Informe de Pruebas de Carga: Plantilla de Benchmarks
Una plantilla estandarizada para documentar resultados de pruebas de carga: throughput, percentiles de latencia, tasas de error, cuellos de botella con evidencia y acciones — con ejemplo k6 resuelto.
Visión General
Los informes de pruebas de carga comunican hallazgos de rendimiento a los interesados y rastrean mejoras a lo largo del tiempo. Sin un formato estándar, cada informe se convierte en una nueva explicación de qué se probó, qué métricas importaban y qué significan los números — y los hallazgos que deberían generar trabajo se pierden en el ruido. Esta plantilla te da una estructura consistente: un resumen ejecutivo para quien decide, tablas escaneables para ingenieros y acciones con responsables para que los resultados se conviertan en correcciones.
Es la mitad de informe de una prueba de carga — la mitad de planificación vive en la Plantilla de Plan de Pruebas de Carga.
Cuándo Usar
- Al reportar resultados después de un ciclo programado de pruebas de carga
- Al compartir hallazgos de rendimiento con product managers o ejecutivos
- Al crear una línea base antes de un lanzamiento mayor o cambio de infraestructura
- Al validar una corrección tras un incidente de rendimiento
Solución
# Informe de Pruebas de Carga

## 1. Resumen Ejecutivo

| Campo | Valor |
|-------|-------|
| Aplicación / Servicio | `nombre` |
| Fecha de Prueba | `YYYY-MM-DD` |
| Entorno | `staging / producción-similar` |
| Herramienta Usada | `k6 / JMeter / Gatling / Locust` |
| Tester | `nombre` |
| Resultado General | `APROBADO / APROBADO con advertencias / REPROBADO` |

- **Objetivo**: Breve declaración de qué se probó y por qué.
- **Hallazgo Clave**: Resumen en una línea del resultado más importante.

## 2. Alcance de la Prueba

- **Endpoints probados**: Lista de URLs o flujos de usuario
- **Perfil de carga**: Usuarios concurrentes, ramp-up, duración, estado estable
- **Datos usados**: Conjuntos de datos realistas, datos de producción anonimizados o sintéticos

## 3. Resultados

### Rendimiento

| Métrica | Objetivo | Actual | Estado |
|---------|----------|--------|--------|
| Peticiones/seg | 1,000 | 1,150 | APROBADO |
| Transacciones/seg | 500 | 480 | APROBADO |

### Latencia (ms)

| Percentil | Objetivo | Actual | Estado |
|-----------|----------|--------|--------|
| p50 | < 100 | 85 | APROBADO |
| p95 | < 300 | 320 | ADVERTENCIA |
| p99 | < 500 | 680 | REPROBADO |

### Tasa de Error

| Métrica | Objetivo | Actual | Estado |
|---------|----------|--------|--------|
| HTTP 5xx | < 0.1% | 0.05% | APROBADO |
| Timeout | < 0.01% | 0.00% | APROBADO |

### Utilización de Recursos

| Recurso | Objetivo | Pico | Estado |
|---------|----------|------|--------|
| CPU | < 70% | 65% | APROBADO |
| Memoria | < 80% | 82% | ADVERTENCIA |
| Conexiones DB | < 80% | 78% | APROBADO |

## 4. Cuellos de Botella Identificados

1. **Cuello de botella**: La consulta X de la base de datos tarda 400ms bajo carga
   - **Impacto**: La latencia p99 excede el objetivo
   - **Evidencia**: Captura del query plan, enlace a trace de APM
   - **Recomendación**: Agregar índice compuesto en `(user_id, created_at)`

2. **Cuello de botella**: Agotamiento del pool de conexiones a 1,200 usuarios
   - **Impacto**: Picos de errores 503
   - **Evidencia**: Enlace a métricas del pool en dashboard
   - **Recomendación**: Aumentar tamaño del pool de 20 a 40

## 5. Acciones

| Prioridad | Acción | Responsable | Fecha Límite |
|-----------|--------|-------------|--------------|
| P0 | Agregar índice en DB para consulta X | @backend-team | 2026-06-28 |
| P1 | Aumentar pool de conexiones | @devops-team | 2026-06-25 |
| P2 | Evaluar capa de caché | @architect | 2026-07-05 |

## 6. Apéndices

- Enlace al repositorio del script de prueba
- Enlace a resultados brutos / exportaciones CSV
- Enlace a dashboards de APM (Grafana, Datadog)
- Enlace al runbook de incidentes si se requiere seguimiento
Explicación
La plantilla separa el resumen (para ejecutivos), los detalles (para ingenieros) y las acciones (para planificación). El formato tabular Objetivo/Actual/Estado hace que el aprobado/reprobado se vea de un vistazo. Los cuellos de botella enlazan a evidencia para que los revisores verifiquen las afirmaciones en lugar de creerlas a ciegas. Las acciones incluyen responsables y fechas — la diferencia entre un informe que cambia cosas y uno que se ojea y se archiva.
Ejemplo Resuelto: Prueba de Carga del Checkout de E-commerce
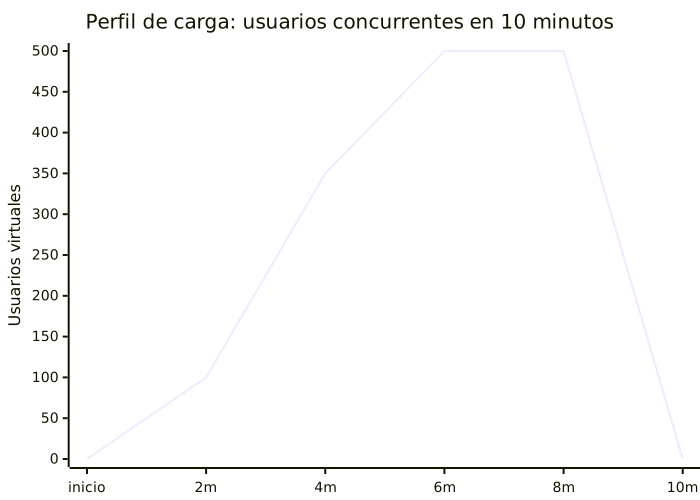
Una prueba de checkout a 500 usuarios ejecutada con k6 — el script, los resultados brutos y cómo se mapean a la plantilla:
// checkout_load.js — rampa a 500 usuarios con umbrales SLO
import http from "k6/http";
import { check, sleep } from "k6";

export const options = {
  stages: [
    { duration: "2m", target: 100 },  // rampa de subida
    { duration: "5m", target: 500 },  // subida al pico
    { duration: "2m", target: 500 },  // estado estable
    { duration: "1m", target: 0 },    // rampa de bajada
  ],
  thresholds: {
    http_req_duration: ["p(95)<300", "p(99)<500"],
    http_req_failed: ["rate<0.01"],
  },
};

export default function () {
  const res = http.post("https://staging.example.com/api/checkout",
    JSON.stringify({ cart_id: "cart_123", payment_method: "card" }),
    { headers: { "Content-Type": "application/json" } });
  check(res, {
    "status es 201": (r) => r.status === 201,
    "respuesta tiene order_id": (r) => r.json("order_id") !== undefined,
  });
  sleep(1);
}
Ejecuta con k6 run --out json=results.json checkout_load.js. Resultado hipotético:
- p50 latencia: 85ms (objetivo < 100ms) APROBADO
- p95 latencia: 320ms (objetivo < 300ms) ADVERTENCIA
- p99 latencia: 680ms (objetivo < 500ms) REPROBADO
- Tasa de error: 0.05% (objetivo < 0.1%) APROBADO
- Rendimiento: 1,150 req/s (objetivo 1,000) APROBADO
El análisis de cuellos de botella que corresponde a la sección 4: la consulta de order_items tarda 400ms bajo carga (falta índice compuesto en (order_id, product_sku)), y el pool de conexiones se agota a 1,200 usuarios concurrentes. Resultado: P0 índice, P1 aumentar pool de 20 a 40, P2 caché Redis para consultas de productos — cada una con responsable y fecha.
Variantes
| Contexto | Enfoque | Notas |
|---|---|---|
| Pre-lanzamiento | Comparación de línea base | Incluir números del lanzamiento anterior lado a lado |
| Recuperación de incidente | Validación post-corrección | Enfocarse en la ruta específica que falló |
| Planificación de capacidad | Prueba de saturación | Documentar el punto de ruptura y el recurso limitante |
| Puerta de regresión en CI | Solo resumen de umbrales | Reportar solo los umbrales fallidos y tendencias |
Lo que Funciona
- Ejecutar pruebas en un entorno que refleje producción — hardware, tamaño de datos y red importan.
- Calentar el sistema antes de registrar métricas para evitar sesgo de arranque en frío.
- Reportar percentiles (p50, p95, p99) en lugar de promedios para que la latencia de cola no se esconda.
- Incluir gráficos y enlaces a dashboards, no solo números estáticos.
- Adjuntar el script exacto de prueba para que cualquiera pueda reproducir la ejecución.
Errores Comunes
- Probar en laptops de desarrollo o entornos subdimensionados.
- Usar conjuntos de datos pequeños que ocultan el rendimiento de consultas del mundo real.
- Reportar solo latencia promedio, que oculta degradación del p99.
- Omitir tasas de error y enfocarse solo en rendimiento.
- Dejar campos requeridos vacíos o escribir respuestas vagas de una palabra.
- Rellenar el informe una vez y nunca actualizarlo cuando el trabajo de seguimiento cambia el panorama.
- No asignar responsable y fecha límite a las acciones, por lo que nada se corrige.
Solución de Problemas
- Los resultados se ven sospechosamente buenos. Normalmente el calentamiento no se excluyó, o los datos de prueba siempre daban en caché. Revisa las tasas de cache hit y el tamaño del dataset antes de celebrar.
- La prueba cae antes que el sistema. El generador de carga es el cuello de botella — una máquina no puede empujar suficiente. Reparte entre runners (k6 Cloud, JMeter distribuido) o reduce el think time.
- Latencias imposiblemente bajas. La prueba corrió desde la misma máquina o segmento de red que el servidor. La latencia medida en localhost no dice nada sobre la experiencia del usuario.
- Los umbrales pasan pero los usuarios se quejan. Estás midiendo el percentil o los endpoints equivocados — el p50 puede verse genial mientras un endpoint pesado de checkout se degrada en p99.
- Los números varían salvajemente entre ejecuciones. El entorno no está aislado — otro job, una VM vecina ruidosa o un evento de autoscaling contaminó la ejecución. Anota las condiciones en el campo Entorno del informe.
Lectura Adicional
Preguntas frecuentes
¿Cómo defino objetivos de latencia y rendimiento?
Los objetivos deben provenir de SLAs, requisitos de producto o líneas base históricas. Si no existen, usa el percentil 80 del tráfico actual de producción como punto de partida — mira la Plantilla de Política de Monitorización y Alertas para cómo se formalizan los objetivos basados en SLO.
¿Debería ejecutar pruebas de carga contra producción?
Evita probar producción directamente. Usa un entorno similar a producción con volumen de datos e infraestructura comparable. Para endpoints de solo lectura, considera traffic mirroring o shadow testing en su lugar.
¿Con qué frecuencia se deben repetir las pruebas de carga?
Antes de cada lanzamiento mayor, después de cambios mayores de infraestructura, y trimestralmente como verificación de regresión. Automatiza pruebas de humo nocturnas con carga pequeña para detectar regresiones temprano.
¿Qué percentiles debo reportar?
Reporta p50 (mediana), p95 y p99 como mínimo. El p50 muestra la experiencia típica, el p95 detecta la mayoría de las degradaciones y el p99 revela latencia de cola que afecta a usuarios reales. Si tienes SLOs en p99.9, inclúyelo también. Nunca reportes solo promedios — ocultan los picos de latencia de cola.
¿Cómo simulo comportamiento realista de usuarios en pruebas de carga?
Usa think time (pausas entre acciones) para coincidir con patrones reales de usuarios. Distribuye requests entre endpoints proporcionalmente al tráfico de producción — flujos de navegación, búsqueda y checkout, no solo el endpoint más pesado. Parametriza los datos de prueba para que cada usuario virtual consulte registros distintos; si no, los cache hits sesgan los resultados.
Recursos Relacionados
Testing de Carga de APIs con k6 y Aserciones Basadas en
Como escribir y ejecutar tests de carga con k6 para medir rendimiento de APIs, validar SLOs e identificar cuellos de botella antes del despliegue a produccion
DocPlantilla de Plan de Pruebas de Carga
Plantilla rellenable de plan de pruebas de carga: escenarios, perfiles de ramp-up, umbrales de éxito, monitoreo y scripts listos para k6, JMeter y Locust.
DocPlantilla de Reporte de Cobertura de Pruebas
Una plantilla para reportar la cobertura de pruebas por módulo, funcionalidad y ruta crítica, con análisis de tendencias e identificación de brechas.
DocPlantilla de Estrategia de Testing de API
Una plantilla para planificar tests de contrato, integración y carga para APIs.
DocPlantilla de Política de Monitoreo y Alertas
Una plantilla de política que define cómo se configuran, enrutan, escalan y revisan las alertas en servicios e infraestructura.
GuideGuía de Estrategia de Testing de Software
Una guía práctica para construir una estrategia de testing en capas con tests unitarios, de integración, de contrato y end-to-end que tu equipo realmente mantendrá.