Guía de Diseño de Bases de Datos
Guía práctica para diseñar bases de datos relacionales con normalización, indexación y modelado de relaciones.
Introducción
Una base de datos bien diseñada es la fundación de aplicaciones confiables. Un mal diseño produce inconsistencias de datos, consultas lentas y migraciones dolorosas. He visto equipos pasar semanas desenredando esquemas que unas pocas decisiones tempranas habrían evitado — la mayoría alrededor de claves, relaciones y normalización.
Esta guía cubre lo esencial para diseñar bases de datos relacionales que escalan: cómo modelar entidades y relaciones, cuándo importa cada forma normal (y cuándo relajarla), cómo funciona realmente la indexación en la práctica y cómo mantener el esquema evolutivo una vez en producción.
Modelado Entidad-Relación
Comienza cada diseño identificando entidades y relaciones. Dibujalo antes de escribir cualquier DDL — un boceto detecta errores de cardinalidad que después cuestan caro.
Pasos
- Identificar entidades: Usuarios, Órdenes, Productos, Categorías
- Definir atributos: ¿Qué datos tiene cada entidad?
- Mapear relaciones: Uno-a-uno, uno-a-muchos, muchos-a-muchos
- Asignar claves: Claves primarias, candidatas, compuestas
Tipos de Relaciones
| Tipo | Ejemplo | Implementación |
|---|---|---|
| Uno-a-Uno | Usuario → Perfil | Clave foránea con constraint único |
| Uno-a-Muchos | Categoría → Productos | Clave foránea en el lado “muchos” |
| Muchos-a-Muchos | Estudiantes ↔ Cursos | Tabla intermedia con dos claves foráneas |
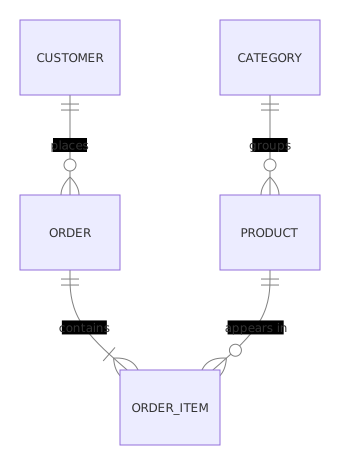
La trampa de muchos-a-muchos es la que más veo: los equipos meten una lista de IDs separada por comas en una columna en lugar de una tabla intermedia, y después no pueden consultarla ni ponerle constraints. Si una relación puede tener más de un valor en cualquiera de los lados, necesita su propia tabla — sin excepciones.
Normalización
La normalización reduce la redundancia y previene anomalías. Seguí estas formas progresivamente — cada una se apoya en la anterior.
Primera Forma Normal (1NF)
- Valores atómicos: sin atributos multivaluados
- Cada fila es única (tiene clave primaria)
-- Violación: varios teléfonos en una sola columna
CREATE TABLE bad_users (
  id INT PRIMARY KEY,
  name VARCHAR(255),
  phones VARCHAR(500) -- '555-1234,555-5678'
);

-- Corrección: tabla separada para teléfonos
CREATE TABLE users (
  id INT PRIMARY KEY,
  name VARCHAR(255)
);

CREATE TABLE user_phones (
  user_id INT REFERENCES users(id),
  phone VARCHAR(20),
  PRIMARY KEY (user_id, phone)
);
Segunda Forma Normal (2NF)
- Debe estar en 1NF
- Sin dependencia parcial: los atributos no clave dependen de la clave primaria completa
-- Violación: order_date depende solo de order_id, no de (order_id, product_id)
CREATE TABLE bad_order_items (
  order_id INT,
  product_id INT,
  order_date DATE,  -- depende solo de order_id
  quantity INT,
  PRIMARY KEY (order_id, product_id)
);

-- Corrección: dividir en orders y order_items
CREATE TABLE orders (
  id INT PRIMARY KEY,
  order_date DATE
);

CREATE TABLE order_items (
  order_id INT REFERENCES orders(id),
  product_id INT,
  quantity INT,
  PRIMARY KEY (order_id, product_id)
);
Tercera Forma Normal (3NF)
- Debe estar en 2NF
- Sin dependencia transitiva: los atributos no clave dependen solo de la clave primaria
-- Violación: city_name depende de zip_code, no de user_id
CREATE TABLE bad_users (
  id INT PRIMARY KEY,
  name VARCHAR(255),
  zip_code VARCHAR(10),
  city_name VARCHAR(100)  -- depende de zip_code
);

-- Corrección: tabla separada para el mapeo zip → ciudad
CREATE TABLE users (
  id INT PRIMARY KEY,
  name VARCHAR(255),
  zip_code VARCHAR(10)
);

CREATE TABLE zip_cities (
  zip_code VARCHAR(10) PRIMARY KEY,
  city_name VARCHAR(100)
);
Cuándo Desnormalizar
3NF es el default correcto, no un dogma. Desnormalizás cuando un problema de performance medido lo justifica — no antes. Un reporte mensual lento es un problema de reporting; se resuelve con una vista materializada o una réplica, no corrompiendo el esquema OLTP.
Los casos legítimos: contadores que se leen miles de veces por segundo (posts.like_count vs contar filas), snapshots de auditoría donde el dato debe quedar congelado al momento de escritura (precios de ítems de factura, dirección de envío en órdenes) y agregados demasiado caros de computar por lectura. Cuando desnormalices, anotá qué columna es derivada y cuál es la fuente de verdad — la próxima persona necesita saber dónde escribir. Para un tratamiento más profundo, mirá la guía de desnormalización.
Estrategias de Indexación
Los índices aceleran lecturas pero ralentizan escrituras. Cada índice es una estructura que la base mantiene en cada INSERT, UPDATE y DELETE — así que tiene que pagar su lugar.
Cuándo Indexar
| Escenario | Tipo de Índice |
|---|---|
| Búsquedas primarias | B-Tree en clave primaria |
| Columnas de clave foránea | B-Tree en columnas FK |
| Búsqueda full-text | Índice full-text |
| Consultas por rango | B-Tree en la columna |
| Datos geoespaciales | GiST / SP-GiST |
Orden de Índices Compuestos
El orden de columnas en un índice compuesto importa: las columnas de la izquierda sirven solas, las de la derecha solo cuando las de la izquierda se filtran. Poné primero las columnas de igualdad y al final la de rango.
-- Bien: status tiene menos valores distintos que created_at
CREATE INDEX idx_orders_created ON orders(created_at, status);

-- Mejor si consultás por status + rango de fecha
CREATE INDEX idx_orders_status_date ON orders(status, created_at);
Ese segundo índice sirve para WHERE status = 'pending' AND created_at > now() - interval '7 days' — el motor usa status para la igualdad y luego recorre el rango de fechas adentro. Invertí el orden y el motor tiene que recorrer todo el rango de fechas para filtrar el status.
Dos cosas que reviso antes de agregar un índice: si la tabla siquiera lo necesita (las tablas chicas hacen sequential scan igual) y si ya existe un índice cuyas columnas de la izquierda cubren la consulta. Los índices duplicados o casi duplicados son comunes en esquemas longevos — pg_stat_user_indexes muestra cuáles nunca se leen. Para el catálogo completo de tipos de índice, la documentación de índices de PostgreSQL es la referencia.
Errores Comunes de Indexación
- Indexación excesiva: cada índice ralentiza INSERT/UPDATE/DELETE
- Indexar columnas de baja cardinalidad solas
- Ignorar índices de cobertura para consultas frecuentes
- Indexar una FK que nunca aparece en un join ni en un WHERE
Constraints e Integridad de Datos
Los constraints son la última línea de defensa del esquema — la capa de aplicación se puede saltear con un script, una migración o un bug; la base de datos no.
CREATE TABLE products (
  id SERIAL PRIMARY KEY,
  sku VARCHAR(50) UNIQUE NOT NULL,
  name VARCHAR(255) NOT NULL,
  price DECIMAL(10,2) CHECK (price >= 0),
  category_id INT REFERENCES categories(id) ON DELETE RESTRICT,
  created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);| Constraint | Propósito |
|---|---|
PRIMARY KEY | Identificador único para cada fila |
UNIQUE | Asegura valores sin duplicados |
NOT NULL | Previene valores faltantes |
CHECK | Valida datos con expresiones |
FOREIGN KEY | Mantiene integridad referencial |
Dos decisiones importan más que el resto. Primero, NOT NULL por defecto: las columnas nulables crean estados invisibles (“¿vacío significa desconocido, sin setear o pendiente?”) y complican las consultas — permití NULL solo donde la ausencia significa algo real. Segundo, el comportamiento ON DELETE: CASCADE para hijos propios (order_items de una orden), RESTRICT para datos de catálogo referenciados (productos en categorías), SET NULL para referencias opcionales. Si no lo elegiste, no decidiste qué pasa cuando algo se borra.
Tipos de Datos y Convenciones de Nombres
La elección de tipos es barata en diseño y cara después. DECIMAL para dinero — nunca FLOAT, que pierde centavos en silencio al redondear. TIMESTAMPTZ en vez de TIMESTAMP: guardar hora local sin zona es fuente recurrente de “por qué este reporte está cinco horas corrido”. TEXT en vez de VARCHAR sin límite en Postgres, donde rinden igual y el límite de largo no compra nada. BIGINT para IDs en tablas que esperás que crezcan — migrar INT a BIGINT en una tabla de órdenes grande implica un lock largo.
Para nombres, elegí una convención y mantenela: snake_case para tablas y columnas, nombres de tabla en plural (orders, users) o singular (order, user) — los equipos se dividen acá, pero mezclar ambas dentro de un esquema es lo que realmente rompe la memoria muscular. Prefijá las claves foráneas con el nombre de la tabla referenciada (customer_id, no fk_1). Nombrá índices idx_{tabla}_{columnas} y constraints chk_{tabla}_{regla} para que un mensaje de error te diga dónde mirar.
Transacciones y Niveles de Aislamiento
El diseño del esquema y la concurrencia están ligados: los constraints e índices que elegís deciden qué puede salir mal cuando dos transacciones tocan las mismas filas. Las transacciones te dan atomicidad (todas las escrituras o ninguna), pero los niveles de aislamiento deciden qué pueden ver las transacciones concurrentes.
| Nivel | Previene | Permite | Costo |
|---|---|---|---|
| Read Committed | Lecturas sucias | Lecturas no repetibles, phantom reads | El más bajo |
| Repeatable Read | + lecturas no repetibles | Phantom reads (Postgres: ninguno) | Medio |
| Serializable | Todo lo anterior | Fallos de serialización que hay que reintentar | El más alto |
Consecuencias de diseño: los constraints únicos hacen el trabajo que el aislamiento no puede (UNIQUE evita dos inserts concurrentes del mismo email sin importar el nivel); SELECT ... FOR UPDATE sobre una fila serializa writers sin escalar toda la transacción; y el modo serializable cambia throughput por corrección — usalo en los pocos flujos críticos (pagos, inventario), no globalmente. Mirá transacciones de base de datos para la mecánica.
Soft Deletes y Columnas de Auditoría
Tarde o temprano todo esquema necesita responder “¿cómo era esta fila el martes pasado?”. Tres columnas cubren el 80%: created_at, updated_at y created_by/updated_by para responsabilidad. Agregalas en diseño — adaptar columnas de auditoría a cuarenta tablas después es una tarea que nadie disfruta.
Soft delete (deleted_at IS NOT NULL) versus DELETE real es una decisión de verdad, no un default. El soft delete gana cuando la fila se referencia desde afuera (órdenes que apuntan a un producto “eliminado”), cuando la recuperación es una necesidad real del producto o cuando el cumplimiento exige trazabilidad. Pierde cuando infla tablas calientes — cada consulta necesita WHERE deleted_at IS NULL y los constraints únicos se vuelven parciales (UNIQUE (email) WHERE deleted_at IS NULL). Delete real más una tabla de archivo/auditoría suele ser mejor reparto para tablas de alto volumen; soft delete para entidades que los usuarios esperan poder recuperar. Lo que elijas, documentalo en los comentarios del esquema.
Migraciones de Esquema en Producción
Los esquemas cambian. Diseñá para eso: cada cambio pasa por un archivo de migración versionado (Flyway, Liquibase, Alembic — elegí uno y mantenelo en control de versiones), y la regla que te salva es la compatibilidad hacia atrás. Agregá una columna nullable, populála y después agregá el constraint — nunca al revés, porque las versiones viejas de la app siguen corriendo contra el esquema nuevo durante los rolling deploys.
Los renombres son dos despliegues, no uno: agregá la columna nueva, sincronizala con un trigger o doble escritura, migrá el código y recién en el release siguiente borrá la vieja. En Postgres, CREATE INDEX CONCURRENTLY evita el lock de tabla; en cualquier motor, las migraciones largas sobre tablas grandes necesitan probarse primero en staging con datos de tamaño productivo.
Lo que funciona
- Usar claves sustitutas (auto-increment o UUIDs) en vez de claves naturales
- Evitar claves foráneas nulas: tablas intermedias para relaciones opcionales
- Elegir tipos de datos cuidadosamente:
VARCHAR(255)vsTEXT,DECIMALvsFLOAT - Documentar el esquema con comentarios y diagramas ER — la plantilla de documentación de esquema te da la estructura
- Planificar el crecimiento: particionar tablas grandes antes de que se conviertan en un problema
Errores Comunes
- Saltarse la normalización por “performance” sin evidencia. Consulta tuning SQL.
- Usar
ENUMpara valores que cambian frecuentemente — una tabla de lookup se actualiza más fácil que una migración - Faltar reglas
ON DELETE/ON UPDATEen claves foráneas. Consulta validación de datos. - Almacenar datos derivados/calculados en vez de computarlos al leer
- Usar
FLOAToDOUBLEpara dinero — los errores de redondeo se acumulan en silencio - Claves naturales como primarias — emails y SKUs cambian, las sustitutas no
Checklist de Revisión de Esquema
Antes de mergear un cambio de esquema, pasá siempre por la misma lista corta:
- Cada tabla tiene clave primaria y cada clave foránea apunta a una real.
- Cada
FOREIGN KEYtiene una decisiónON DELETEexplícita, no el default. - El dinero es
DECIMAL, los timestamps sonTIMESTAMPTZ, los IDs sonBIGINTdonde se espera crecimiento. NOT NULLen todo excepto en columnas donde la ausencia significa algo.- Las claves foráneas y columnas de lookup nuevas tienen índices de soporte.
- Las reglas de negocio únicas existen como constraints (
UNIQUE,CHECK), no solo en código de aplicación. - Los valores tipo enum nuevos fueron a una tabla de lookup, no a un tipo hardcodeado.
- La migración está versionada, es compatible hacia atrás y se probó en staging contra datos de tamaño productivo.
Cinco minutos contra esta lista detectan los fallos que después cuestan días — índices FK faltantes, deletes en cascada accidentales y columnas de dinero en float son todos silenciosos hasta que salen caros.
Troubleshooting
- Esquema sobre-normalizado que enlentece cada consulta: si un listado rutinario necesita cinco joins, pasaste el punto útil. Desnormalizá ese path de lectura concreto o agregá una vista materializada — no aplanes todo el esquema.
- FK sin índice: los deletes y updates sobre el padre escanean-lock la tabla hija. Indexá toda FK que participe en joins o cascadas.
ENUMque no acepta un valor nuevo sin migración: reemplazalo por una tabla de lookup + clave foránea.- Deadlocks bajo concurrencia: transacciones que tocan tablas en orden distinto se bloquean entre sí. Establecé un orden de escritura consistente — padre primero, hijos después — y mantené las transacciones cortas. Mirá deadlocks y reintentos en bases de datos.
- Los TIMESTAMP se mueven entre servidores: servidores de aplicación en zonas distintas escriben horas locales. Cambiá la columna a
TIMESTAMPTZ— la migración reescribe la tabla, planificala.
Temas Avanzados
Escenario: Diseño de Esquema E-commerce
-- Sistema: 10M productos, 500K órdenes/día
-- ACID para órdenes, búsqueda de catálogo rápida, precisión de inventario

CREATE TABLE customers (
    id BIGSERIAL PRIMARY KEY,
    email VARCHAR(255) UNIQUE NOT NULL,
    first_name VARCHAR(100) NOT NULL,
    last_name VARCHAR(100) NOT NULL,
    phone VARCHAR(20),
    created_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE TABLE addresses (
    id BIGSERIAL PRIMARY KEY,
    customer_id BIGINT NOT NULL REFERENCES customers(id) ON DELETE CASCADE,
    line1 VARCHAR(255) NOT NULL, city VARCHAR(100) NOT NULL,
    state VARCHAR(50) NOT NULL, postal_code VARCHAR(20) NOT NULL,
    country CHAR(2) DEFAULT 'US', is_default BOOLEAN DEFAULT FALSE
);

CREATE TABLE categories (
    id BIGSERIAL PRIMARY KEY,
    parent_id BIGINT REFERENCES categories(id) ON DELETE SET NULL,
    name VARCHAR(100) NOT NULL, slug VARCHAR(100) UNIQUE NOT NULL
);

CREATE TABLE products (
    id BIGSERIAL PRIMARY KEY,
    sku VARCHAR(50) UNIQUE NOT NULL,
    name VARCHAR(255) NOT NULL, description TEXT,
    category_id BIGINT REFERENCES categories(id) ON DELETE RESTRICT,
    price DECIMAL(10,2) NOT NULL CHECK (price >= 0),
    is_active BOOLEAN DEFAULT TRUE,
    created_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE TABLE orders (
    id BIGSERIAL PRIMARY KEY,
    customer_id BIGINT NOT NULL REFERENCES customers(id),
    status VARCHAR(20) DEFAULT 'pending',
    subtotal DECIMAL(10,2) NOT NULL,
    shipping_cost DECIMAL(10,2) DEFAULT 0,
    tax DECIMAL(10,2) DEFAULT 0,
    total DECIMAL(10,2) NOT NULL,
    created_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE TABLE order_items (
    id BIGSERIAL PRIMARY KEY,
    order_id BIGINT NOT NULL REFERENCES orders(id) ON DELETE CASCADE,
    product_id BIGINT NOT NULL REFERENCES products(id),
    quantity INT NOT NULL CHECK (quantity > 0),
    unit_price DECIMAL(10,2) NOT NULL,
    line_total DECIMAL(10,2) GENERATED ALWAYS AS (quantity * unit_price) STORED
);

-- Índices para consultas habituales
CREATE INDEX idx_orders_customer ON orders(customer_id, created_at DESC);
CREATE INDEX idx_products_category ON products(category_id) WHERE is_active = true;
CREATE INDEX idx_order_items_product ON order_items(product_id);
CREATE INDEX idx_products_search ON products USING GIN(to_tsvector('english', name || ' ' || description));
Fijate en las decisiones de diseño: line_total como columna generada (dato derivado sin duplicación almacenada), el índice parcial sobre is_active (indexá solo lo que consultás), ON DELETE CASCADE para hijos propios y RESTRICT para datos de catálogo referenciados, y DECIMAL en cada columna de dinero. Esto es 3NF más una desnormalización deliberada: addresses guarda la dirección de envío tal como era al momento de la orden — la orden no debe cambiar si el cliente después edita su libreta de direcciones.
Preguntas frecuentes
¿Qué forma normal debería alcanzar un diseño de base de datos?
La mayoría de las aplicaciones deberían normalizar hasta la Tercera Forma Normal (3NF). Elimina dependencias transitivas y mantiene los datos consistentes sin fragmentar entidades. Andá más allá (BCNF, 4NF) solo cuando el modelo lo exige, y desnormalizá solo con evidencia medida de un problema de performance.
¿Cuándo debería usar un índice compuesto?
Cuando las consultas filtran por varias columnas juntas — WHERE status = 'pending' AND created_at > X se beneficia de (status, created_at). Poné primero las columnas de igualdad y al final la de rango, y evitá índices compuestos donde cada columna ya tiene el suyo y el optimizador puede combinarlos.
¿Debería usar UUID o auto-increment para claves primarias?
Enteros auto-increment para la mayoría de apps OLTP — índices más chicos, mejor localidad, legibles en logs. UUIDs cuando generás IDs en varios lugares (writers distribuidos, clientes móviles que crean registros offline, bases fusionadas). UUIDv7 mantiene el beneficio de timestamp ordenable si querés ambas cosas.
¿Cómo evito que el inventario venda de más?
SELECT ... FOR UPDATE dentro de una transacción, o un decremento atómico con check constraint:
BEGIN;
UPDATE product_variants SET stock = stock - 1
WHERE id = ? AND stock > 0;
-- Si affected rows = 0, sin stock
COMMIT;
La versión atómica no necesita lock explícito — la sentencia tiene éxito o devuelve cero filas.
¿Cuál es el orden correcto para normalizar un esquema existente desordenado?
Empezá por las claves primarias y foráneas faltantes — integridad primero. Después separá las violaciones de 1NF más claras (columnas multivaluadas) porque bloquean todo lo demás. Terminá con la limpieza 2NF/3NF de dependencias parciales y transitivas, un grupo de tablas por vez, con una migración por paso.
¿Cuándo una tabla de lookup le gana a un ENUM?
En cuanto el conjunto de valores puede cambiar en runtime, es editable por usuarios o necesita metadata (nombre visible, orden, flag activo). Un ENUM exige una migración por cada valor nuevo; una tabla de lookup es un INSERT y puede llevar columnas extra. ENUM está bien para conjuntos realmente cerrados, como días de la semana.
Recursos Relacionados
SQL Joins — Guía Visual con Ejemplos
Guía visual de SQL joins: INNER, LEFT, RIGHT, FULL OUTER, CROSS y SELF joins con ejemplos prácticos, tips de rendimiento y errores comunes.
RecipeTransacciones de Base de Datos en Python, JS y Java
Cómo usar transacciones ACID para garantizar integridad de datos en Python, JavaScript y Java con ejemplos SQL.
GuideDesnormalización: espacio por velocidad de lectura
Guía práctica de desnormalización de bases de datos: cuándo cambiar almacenamiento por rendimiento de lectura y mantener datos consistentes.
GuideOptimización de Rendimiento SQL
Una guía práctica para optimizar consultas SQL: estrategias de indexación, reescritura de queries, análisis de EXPLAIN plans y anti-patrones comunes a evitar.
DocPlantilla de Documentación de Esquema de Base de Datos
Una plantilla para documentar esquemas de base de datos con relaciones entre entidades, definiciones de campos e historial de migraciones.
GuideGuía de Selección NoSQL — MongoDB, DynamoDB, Cassandra
Guía práctica para elegir la base de datos NoSQL correcta. Compara documentos, clave-valor, columnas anchas y grafos con criterios de selección.