Patrón Eager Loading: resuelve el problema N+1
Carga datos relacionados en una sola consulta en lugar de múltiples llamadas a la base de datos, evitando el problema N+1 y mejorando el rendimiento de lectura.
Descripción General
El patrón Eager Loading carga los datos relacionados junto con la entidad principal en una sola consulta, en lugar de emitir una consulta distinta por cada relación. Así se evita el problema N+1: cargar N entidades y disparar después N consultas adicionales para sus datos relacionados, lo que suma N+1 llamadas a la base de datos.
La mayoría de los ORMs y capas de acceso a datos ofrecen carga anticipada mediante JOINs de SQL, consultas IN por lotes o subconsultas. El enfoque contrario, la carga diferida (lazy loading), pospone los datos relacionados hasta que el código los necesita de verdad: menos filas por adelantado a cambio de más consultas después.
Cuándo Usar
Usa el patrón Eager Loading cuando:
- Sabes de antemano qué relaciones va a consumir el llamador, como un endpoint de listado que siempre muestra el propietario de cada elemento.
- El problema N+1 es medible: los logs de consultas o un profiler muestran decenas de consultas pequeñas por petición.
- Cada elemento de una lista renderizada necesita datos relacionados, así que cada fila obtenida dispararía al menos una consulta extra.
- La latencia de red entre la aplicación y la base de datos es lo bastante alta como para que las idas y vueltas dominen el tiempo total.
Cuándo Evitar
- Solo necesitas los datos relacionados para un subconjunto pequeño de entidades; la carga diferida los trae bajo demanda.
- La relación contiene datos pesados (documentos, imágenes, blobs JSON) que la mayoría de peticiones nunca lee.
- La memoria es limitada y materializar el grafo de objetos completo de una vez es prohibitivo.
- El JOIN es lo bastante complejo como para degradar la base de datos más que varias consultas pequeñas bien indexadas.
- Estás paginando una entidad padre sobre un JOIN uno-a-muchos; mira Carga anticipada y paginación más abajo.
Solución
Python
from dataclasses import dataclass
from typing import List, Optional
import sqlite3

@dataclass
class Author:
    id: int
    name: str

@dataclass
class Book:
    id: int
    title: str
    author_id: int
    author: Optional[Author] = None

class BookRepository:
    def __init__(self, conn):
        self._conn = conn

    # Problema N+1 (MALO)
    def find_all_with_authors_naive(self) -> List[Book]:
        books = []
        for row in self._conn.execute("SELECT id, title, author_id FROM books"):
            book = Book(id=row["id"], title=row["title"], author_id=row["author_id"])
            # ¡Una consulta adicional por libro!
            author_row = self._conn.execute(
                "SELECT id, name FROM authors WHERE id = ?", (book.author_id,)
            ).fetchone()
            if author_row:
                book.author = Author(id=author_row["id"], name=author_row["name"])
            books.append(book)
        return books

    # Eager Loading (BUENO): una sola consulta con JOIN
    def find_all_with_authors_eager(self) -> List[Book]:
        query = """
            SELECT b.id AS book_id, b.title, b.author_id,
                   a.id AS author_id, a.name AS author_name
            FROM books b
            JOIN authors a ON b.author_id = a.id
        """
        books = []
        for row in self._conn.execute(query):
            author = Author(id=row["author_id"], name=row["author_name"])
            book = Book(
                id=row["book_id"],
                title=row["title"],
                author_id=row["author_id"],
                author=author
            )
            books.append(book)
        return books

    # Carga por lotes: dos consultas, sin JOIN
    def find_all_with_authors_batch(self) -> List[Book]:
        books = []
        rows = self._conn.execute("SELECT id, title, author_id FROM books").fetchall()
        author_ids = [r["author_id"] for r in rows]

        # Una sola consulta para todos los autores
        placeholders = ",".join("?" * len(author_ids))
        authors = {
            r["id"]: Author(id=r["id"], name=r["name"])
            for r in self._conn.execute(
                f"SELECT id, name FROM authors WHERE id IN ({placeholders})", author_ids
            )
        }

        for row in rows:
            book = Book(
                id=row["id"],
                title=row["title"],
                author_id=row["author_id"],
                author=authors.get(row["author_id"])
            )
            books.append(book)
        return books


# Preparación
conn = sqlite3.connect(":memory:")
conn.row_factory = sqlite3.Row
conn.execute("CREATE TABLE authors (id INTEGER PRIMARY KEY, name TEXT)")
conn.execute("CREATE TABLE books (id INTEGER PRIMARY KEY, title TEXT, author_id INTEGER)")
conn.execute("INSERT INTO authors (name) VALUES ('Alice'), ('Bob')")
conn.execute("INSERT INTO books (title, author_id) VALUES ('Book A', 1), ('Book B', 1), ('Book C', 2)")

repo = BookRepository(conn)
books = repo.find_all_with_authors_eager()
for book in books:
    print(f"{book.title} by {book.author.name}")
Java
Las clases de abajo omiten el modificador public para que todo el ejemplo compile en un solo archivo (javac EagerLoading.java). En un proyecto real cada clase viviría en su propio archivo.
import java.sql.*;
import java.util.*;

class Author {
    private final int id;
    private final String name;
    public Author(int id, String name) { this.id = id; this.name = name; }
    public int getId() { return id; }
    public String getName() { return name; }
}

class Book {
    private final int id;
    private final String title;
    private final int authorId;
    private Author author;

    public Book(int id, String title, int authorId) {
        this.id = id; this.title = title; this.authorId = authorId;
    }
    public int getId() { return id; }
    public String getTitle() { return title; }
    public Author getAuthor() { return author; }
    public void setAuthor(Author author) { this.author = author; }
}

class BookRepository {
    private final Connection conn;
    public BookRepository(Connection conn) { this.conn = conn; }

    public List<Book> findAllWithAuthors() throws SQLException {
        String query = """
            SELECT b.id AS book_id, b.title, b.author_id,
                   a.id AS author_id, a.name AS author_name
            FROM books b
            JOIN authors a ON b.author_id = a.id
            """;
        List<Book> books = new ArrayList<>();
        try (Statement stmt = conn.createStatement();
             ResultSet rs = stmt.executeQuery(query)) {
            while (rs.next()) {
                Author author = new Author(rs.getInt("author_id"), rs.getString("author_name"));
                Book book = new Book(rs.getInt("book_id"), rs.getString("title"), rs.getInt("author_id"));
                book.setAuthor(author);
                books.add(book);
            }
        }
        return books;
    }
}

// Uso
Connection conn = DriverManager.getConnection("jdbc:sqlite::memory:");
conn.createStatement().execute("CREATE TABLE authors (id INTEGER PRIMARY KEY, name TEXT)");
conn.createStatement().execute("CREATE TABLE books (id INTEGER PRIMARY KEY, title TEXT, author_id INTEGER)");
conn.createStatement().execute("INSERT INTO authors (name) VALUES ('Alice'), ('Bob')");
conn.createStatement().execute("INSERT INTO books (title, author_id) VALUES ('Book A', 1), ('Book B', 1), ('Book C', 2)");

BookRepository repo = new BookRepository(conn);
for (Book book : repo.findAllWithAuthors()) {
    System.out.println(book.getTitle() + " by " + book.getAuthor().getName());
}
JavaScript
El repositorio de abajo funciona sobre node:sqlite (incluido en Node ≥ 22.13), así que el bloque de uso se ejecuta de verdad en lugar de quedarse como pseudocódigo.
const { DatabaseSync } = require('node:sqlite');

class Author {
  constructor(id, name) {
    this.id = id;
    this.name = name;
  }
}

class Book {
  constructor(id, title, authorId) {
    this.id = id;
    this.title = title;
    this.authorId = authorId;
    this.author = null;
  }
}

class BookRepository {
  constructor(db) {
    this.db = db;
  }

  // Problema N+1 (MALO)
  findAllWithAuthorsNaive() {
    const books = this.db.prepare('SELECT id, title, author_id FROM books').all()
      .map(r => new Book(r.id, r.title, r.author_id));
    for (const book of books) {
      const author = this.db.prepare('SELECT id, name FROM authors WHERE id = ?')
        .get(book.authorId);
      book.author = author ? new Author(author.id, author.name) : null;
    }
    return books;
  }

  // Eager Loading (BUENO)
  findAllWithAuthorsEager() {
    const rows = this.db.prepare(`
      SELECT b.id AS book_id, b.title, b.author_id,
             a.id AS author_id, a.name AS author_name
      FROM books b
      JOIN authors a ON b.author_id = a.id
    `).all();
    return rows.map(r => {
      const book = new Book(r.book_id, r.title, r.author_id);
      book.author = new Author(r.author_id, r.author_name);
      return book;
    });
  }

  // Carga por lotes
  findAllWithAuthorsBatch() {
    const books = this.db.prepare('SELECT id, title, author_id FROM books').all()
      .map(r => new Book(r.id, r.title, r.author_id));
    const authorIds = [...new Set(books.map(b => b.authorId))];
    const authors = this.db.prepare(
      `SELECT id, name FROM authors WHERE id IN (${authorIds.join(',')})`
    ).all();
    const authorMap = new Map(authors.map(a => [a.id, new Author(a.id, a.name)]));

    for (const book of books) {
      book.author = authorMap.get(book.authorId) || null;
    }
    return books;
  }
}

// Uso
const db = new DatabaseSync(':memory:');
db.exec(`
  CREATE TABLE authors (id INTEGER PRIMARY KEY, name TEXT);
  CREATE TABLE books (id INTEGER PRIMARY KEY, title TEXT, author_id INTEGER);
  INSERT INTO authors (name) VALUES ('Alice'), ('Bob');
  INSERT INTO books (title, author_id) VALUES ('Book A', 1), ('Book B', 1), ('Book C', 2);
`);

const repo = new BookRepository(db);
for (const book of repo.findAllWithAuthorsEager()) {
  console.log(`${book.title} by ${book.author.name}`);
}
Explicación
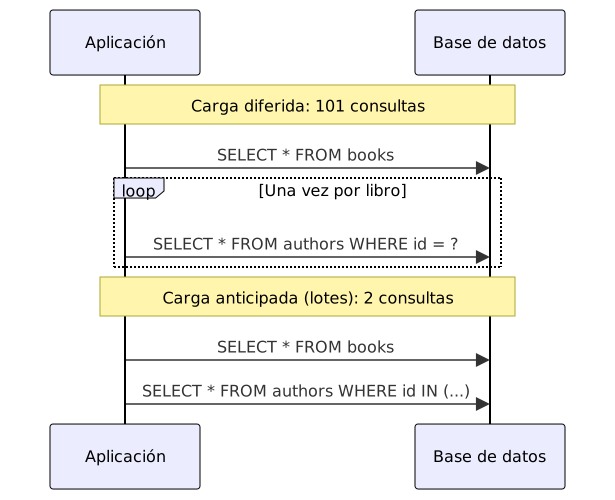
Cargar 100 libros de la forma ingenua cuesta 101 consultas:
SELECT id, title, author_id FROM booksdevuelve los 100 libros.SELECT id, name FROM authors WHERE id = ?se ejecuta una vez por libro.
La carga anticipada lo reduce a una sola ida y vuelta con un JOIN:
SELECT b.id, b.title, b.author_id, a.id AS author_id, a.name
FROM books b
JOIN authors a ON b.author_id = a.id
o a dos idas y vueltas con la carga por lotes: una consulta para los libros y otra con WHERE id IN (...) para todos los autores referenciados a la vez.
Por qué los ORMs mezclan JOIN y lotes
El JOIN no es una victoria gratis. Unir un padre con una única relación a-uno (books -> authors) es seguro porque el número de filas no crece. Unir a través de una relación a-muchos repite la fila del padre una vez por hijo, y unir dos relaciones a-muchos las multiplica: 100 libros con 3 etiquetas cada uno ya producen 300 filas, y añadir un segundo JOIN a-muchos hacia reviews vuelve a multiplicar.
Por eso los ORMs maduros aplican estrategias distintas según la cardinalidad: JOIN para las relaciones a-uno (select_related, Include, joinedload) y una segunda consulta IN por lotes para las colecciones a-muchos (prefetch_related, AsSplitQuery, selectinload). Obtienes semántica de carga anticipada sin el producto cartesiano.
Carga Anticipada y Paginación
La paginación choca con los JOINs sobre relaciones a-muchos. LIMIT se aplica a las filas del resultado, y un books JOIN chapters repite la fila del libro una vez por capítulo, así que LIMIT 10 puede devolver apenas dos o tres libros.
Todos los ORMs importantes lo resuelven igual: ignoran el JOIN en la consulta de la página, paginan los padres y luego traen la colección con una consulta IN por lotes usando esos IDs de padre. Hibernate avisa exactamente de esto cuando combinas setMaxResults con una colección: “firstResult/maxResults specified with collection fetch; applying in memory”. El respaldo en memoria funciona, pero carga en silencio todo el JOIN sin paginar en la JVM primero.
Cómo Detectar el Problema N+1 en la Práctica
El N+1 rara vez aparece como una consulta lenta; aparece como número de consultas. Formas concretas de verlo:
- Django:
assertNumQueries(3)dentro de un test, o Django Debug Toolbar en desarrollo, muestra cada sentencia por petición. - Hibernate / JPA:
hibernate.generate_statistics=trueinforma del número de consultas por sesión; una sesión que ejecuta cientos de selects es una señal de alerta. - SQLAlchemy:
create_engine(url, echo=True)registra cada sentencia SQL durante el desarrollo. - Prisma / Node: suscríbete al evento
query(prisma.$on('query', ...)) y registrae.durationpor sentencia. - PostgreSQL en producción:
pg_stat_statementsmuestra la misma consulta de autor ejecutada decenas de miles de veces por hora, algo que ningún índice arregla.
Variantes
| Variante | Mecanismo | Caso de uso |
|---|---|---|
| JOIN | Una sola consulta SQL con JOIN | Relaciones a-uno, conjuntos de datos pequeños y medianos |
| Lotes / cláusula IN | Dos consultas con una lista IN | Colecciones a-muchos, padres paginados, evitar productos cartesianos |
| Subconsulta | Subconsulta correlacionada para datos relacionados | Bases de datos donde el optimizador maneja mejor subconsultas que JOINs anchos |
| GraphQL DataLoader | Agrupa y deduplica por petición | APIs con formas de consulta dinámicas; ver lotes con DataLoader |
Lo que Funciona
- Mide antes de optimizar. Aserciones sobre el número de consultas (
assertNumQueries, estadísticas de Hibernate, un log conecho) para arreglar un N+1 probado y no uno supuesto. - JOIN para a-uno, lotes para a-muchos. Refleja lo que hacen los ORMs por dentro y evita los productos cartesianos que encarecen los JOINs sobre colecciones.
- Selecciona solo las columnas que necesitas.
SELECT *en un JOIN trae todas las columnas de ambas tablas; nombra los campos que el llamador realmente lee. - Elige el plan de carga por caso de uso. Una vista de detalle y una exportación masiva necesitan grafos de objetos distintos; casi todos los ORMs permiten elegir la estrategia por consulta en lugar de por entidad.
- Vigila la memoria en grafos grandes. La carga anticipada de un grafo profundo puede materializar miles de objetos; carga por lotes y pagina en su lugar.
Errores Comunes
- Cargar todo de forma anticipada por defecto. Marcar todas las relaciones como eager construye grafos de objetos enormes que nadie pidió.
- Usar carga diferida dentro de un bucle. Iterar entidades y tocar
book.authoren cada elemento es exactamente cómo se produce el N+1. - Ignorar los productos cartesianos. Unir dos relaciones a-muchos multiplica las filas; el conjunto de resultados crece de forma cuadrática, no lineal.
- Unir una colección a-muchos mientras se pagina.
LIMITcuenta filas unidas, no padres, así que las páginas vuelven incompletas o el ORM recurre a paginación en memoria. - Asumir que el JOIN siempre gana. Con conjuntos de datos grandes o tablas distantes, dos consultas indexadas pueden superar a un JOIN ancho; mide ambos.
Ejemplos del Mundo Real
Django ORM
Book.objects.select_related('author') emite un JOIN para relaciones a-uno, mientras que prefetch_related('tags') lanza una segunda consulta para relaciones a-muchos y cose los resultados en Python. Ver la documentación de querysets de Django.
SQLAlchemy
session.query(Book).options(joinedload(Book.author)) produce el JOIN, y selectinload(Book.tags) produce la consulta IN por lotes. La misma división JOIN-para-a-uno, lotes-para-a-muchos; ver la documentación de carga de relaciones de SQLAlchemy.
Entity Framework Core
.Include(b => b.Author) une las relaciones a-uno. Desde EF Core 5, .AsSplitQuery() divide los includes a-muchos en consultas separadas, evitando las filas de padre duplicadas que produciría un solo JOIN. Ver la documentación de carga anticipada de EF Core.
Rails Active Record
Book.includes(:author) elige entre preload (una consulta por lotes separada) y eager_load (un LEFT JOIN) según si la consulta filtra sobre la asociación. Ver la guía de consultas de Rails.
Prisma
prisma.book.findMany({ include: { author: true } }) resuelve las relaciones con consultas por lotes en lugar de un JOIN, razón por la que Prisma evita el N+1 sin exponer una API de estrategia de carga.
GraphQL DataLoader
DataLoader agrupa y deduplica cargas idénticas de un campo entre objetos padre en cada petición, resolviendo el N+1 en la capa de resolvers en lugar de la capa del ORM. La receta de lotes con DataLoader muestra una implementación funcional.
Véase También
- Repositorio companion ejecutable — los ejemplos en Python, JavaScript y Java de esta página como archivos ejecutables.
- Carga diferida de imágenes, componentes y datos — la contrapartida, aplicada a recursos de frontend.
- Guía de optimización de consultas SQL — índices y análisis de planes para cuando la carga anticipada no basta.
Preguntas frecuentes
¿Qué es el problema N+1?
Cargar N entidades y emitir luego una consulta extra por entidad para los datos relacionados, lo que produce N+1 consultas donde bastarían una o dos. Aparece siempre que el código itera una colección y toca una relación de carga diferida dentro del bucle.
¿Cuándo debo elegir la carga por lotes en lugar de un JOIN?
Elige la carga por lotes para colecciones a-muchos, para padres paginados y siempre que un JOIN produjera un producto cartesiano. Elige un JOIN para relaciones a-uno y conjuntos de resultados pequeños donde una sola ida y vuelta es lo más barato.
¿Funciona la carga anticipada con paginación?
Solo con cuidado. Unir una colección a-muchos y aplicar LIMIT cuenta filas unidas, no padres, así que las páginas devuelven menos padres de los esperados. Los ORMs lo gestionan paginando primero los padres y cargando la colección por lotes después.
¿Es la carga anticipada siempre mejor que la diferida?
No. La carga anticipada gana cuando sabes que vas a usar los datos; la diferida gana cuando los datos son opcionales, grandes o solo necesarios en un subconjunto de filas. El valor por defecto equivocado en cualquiera de las dos direcciones desperdicia consultas o memoria.
¿Cómo detecto consultas N+1 en producción?
Observa el número de consultas, no su latencia. Activa el registro de consultas por petición (estadísticas de Hibernate, echo de SQLAlchemy, un listener de query en Prisma) o revisa pg_stat_statements buscando consultas idénticas ejecutadas miles de veces.
Recursos Relacionados
Patrón Data Mapper: dominio sin dependencia de la BD
Separa objetos de dominio en memoria de la base de datos delegando la persistencia a una capa de mappers dedicada, manteniendo los modelos framework-agnostic.
PatternPatrón Identity Map
Cachea objetos por clave primaria para que cada fila corresponda a una instancia en memoria por transacción. Sin duplicados ni actualizaciones perdidas.
RecipeImplementar Lazy Loading para Imágenes, Componentes y Datos
Cómo diferir la carga de recursos no críticos hasta que sean necesarios, mejorando el tiempo de carga inicial de página, reduciendo el ancho de banda y optimizando Core Web Vitals.
RecipeBatch y cache de consultas con GraphQL DataLoader
Usa DataLoader para agrupar peticiones de carga individuales en llamadas batch a la base de datos, resolviendo el problema N+1 en resolvers GraphQL
GuideGuía Completa de Optimización de Consultas SQL
Detecta y corrige consultas SQL lentas: lee planes EXPLAIN, indexa bien, elimina consultas N+1 y aplica particionamiento, pooling y caché en PostgreSQL y MySQL.