Caching con Redis
Cómo implementar caching de aplicaciones usando Redis para rendimiento y escalabilidad.
Visión General
Tu página de producto ejecuta el mismo SELECT dos mil veces por minuto, y cada copia devuelve datos idénticos. Esa es la carga de trabajo para la que existe el caching — y por qué una sola instancia de Redis delante de la base de datos puede cortar la carga de consultas en un orden de magnitud.
Redis es un almacén de datos en memoria: las lecturas se resuelven en microsegundos en lugar de los milisegundos que cuesta un round-trip a la base de datos. Esta receta implementa los patrones que importan en la práctica — cache-aside para lecturas, TTLs para acotar lo obsoleto, invalidación segura en escrituras — en Python, JavaScript y Java. Para un recorrido centrado en Node.js, consulta caching en Node.js con Redis; para la visión a nivel de estrategia, la guía de estrategias de caching con Redis compara cada patrón en profundidad.
Cuándo Usar
Usa este recurso cuando:
- Las consultas a base de datos son lentas y devuelven los mismos resultados frecuentemente
- Necesitas reducir carga en APIs o bases de datos downstream
- Datos de sesión, perfiles de usuario o configuración necesitan acceso rápido de lectura
- Se requieren leaderboards en tiempo real, rate limiting o locks temporales
Solución
Python (redis-py)
import json
import redis
from functools import wraps

r = redis.Redis(host="localhost", port=6379, decode_responses=True)

# Helper cache-aside
def cached(key_prefix, ttl=300):
    def decorator(func):
        @wraps(func)
        def wrapper(*args, **kwargs):
            cache_key = f"{key_prefix}:{args}:{kwargs}"
            cached = r.get(cache_key)
            if cached:
                return json.loads(cached)
            result = func(*args, **kwargs)
            r.setex(cache_key, ttl, json.dumps(result))
            return result
        return wrapper
    return decorator

@cached("user_profile", ttl=600)
def get_user(user_id):
    # Consulta DB costosa
    return {"id": user_id, "name": "Alice", "orders": 42}

# Invalidación manual de caché
r.delete("user_profile:(1,):{}")

# Redis como almacén de sesiones
r.setex("session:abc123", 3600, json.dumps({"user_id": 1, "role": "admin"}))
JavaScript (ioredis)
const Redis = require("ioredis");
const redis = new Redis({ host: "localhost", port: 6379 });

async function getCached(key, fetcher, ttl = 300) {
  const cached = await redis.get(key);
  if (cached) return JSON.parse(cached);

  const data = await fetcher();
  await redis.setex(key, ttl, JSON.stringify(data));
  return data;
}

async function getUser(userId) {
  return getCached(`user:${userId}`, async () => {
    // Consulta DB costosa
    return { id: userId, name: "Alice", orders: 42 };
  }, 600);
}

// Invalidar caché
async function invalidateUser(userId) {
  await redis.del(`user:${userId}`);
}

// Redis como rate limiter
async function rateLimit(key, maxRequests = 100, window = 60) {
  const current = await redis.incr(key);
  if (current === 1) await redis.expire(key, window);
  return current <= maxRequests;
}
Java (Jedis + Spring Cache)
import redis.clients.jedis.Jedis;
import redis.clients.jedis.JedisPool;
import org.springframework.cache.annotation.Cacheable;
import org.springframework.cache.annotation.CacheEvict;
import org.springframework.stereotype.Service;

@Service
public class UserService {

    // Spring declarative caching
    @Cacheable(value = "users", key = "#userId")
    public User getUser(Long userId) {
        // Consulta DB costosa
        return new User(userId, "Alice", 42);
    }

    @CacheEvict(value = "users", key = "#userId")
    public void updateUser(Long userId, User user) {
        // Actualizar DB
    }
}

// Caching manual con Jedis
public class CacheClient {
    private final JedisPool pool = new JedisPool("localhost", 6379);

    public String get(String key) {
        try (Jedis jedis = pool.getResource()) {
            return jedis.get(key);
        }
    }

    public void setex(String key, int seconds, String value) {
        try (Jedis jedis = pool.getResource()) {
            jedis.setex(key, seconds, value);
        }
    }
}
Explicación
El patrón cache-aside (o lazy-loading) es la estrategia de caching más común:
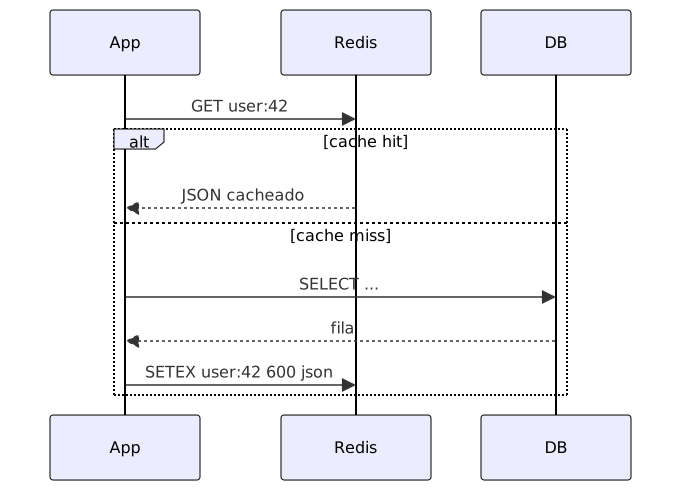
- Lectura: Revisa el caché primero. Si hay hit, retorna inmediatamente. Si hay miss, obtiene de la DB, guarda en caché y retorna.
- Escritura: Actualiza la base de datos, luego invalida o actualiza el caché.
- TTL: Cada entrada cacheada tiene un Time-To-Live. Cuando expira, la entrada es expulsada y la siguiente lectura obtiene datos frescos.
El TTL hace más trabajo del que parece: acota cuánto puede quedar obsoleto un valor cacheado, lo que significa que puedes ser laxo con la invalidación a cambio de un peor caso conocido. TTL corto en datos volátiles, largo en datos de referencia — la garantía de frescura es un dial, no un interruptor.
Este patrón es simple, funciona con cualquier base de datos y maneja fallos de caché elegantemente: si Redis cae, la app recurre a la base de datos (degradación de caché, no caída total).
Variantes
| Estrategia | Cuándo Usar | Trade-off |
|---|---|---|
| Cache-Aside | Apps con muchas lecturas | Simple, pero caché y DB pueden divergir |
| Write-Through | Consistencia fuerte requerida | Escrituras más lentas, caché siempre fresco |
| Write-Behind | Alto throughput de escritura | Riesgo de pérdida de datos si caché crashea antes del flush |
| Read-Through | Lógica de invalidación compleja | La librería de caché maneja el fetching |
| Redis Pub/Sub | Invalidación de caché entre instancias | Sync en tiempo real, pero añade complejidad |
Patrones Avanzados
La tabla anterior es el menú; las implementaciones de abajo son las que escribirás de verdad. Dos familias de patrones aparecen en todo caché en producción: estrategias del lado de escritura (qué pasa cuando cambian los datos) y los trucos específicos de Redis que hacen cache-aside seguro bajo carga. Los helpers principales son ejecutables en el repositorio companion.
Patrón Write-Through Cache
Elige write-through cuando una lectura nunca debe ver datos obsoletos: cada escritura actualiza la base de datos y el caché a la vez, así que el caché siempre está fresco a costa de latencia de escritura.
import json
import redis

r = redis.Redis(host="localhost", port=6379, decode_responses=True)

def write_through_user(user_id: int, data: dict, db_update_fn):
    """Escribir a caché y base de datos atómicamente."""
    cache_key = f"user:{user_id}"

    # Actualizar base de datos primero
    db_update_fn(user_id, data)

    # Luego actualizar caché
    r.setex(cache_key, 600, json.dumps(data))

# Uso
def db_update_user(user_id, data):
    # Ejecutar SQL UPDATE
    pass

write_through_user(42, {"id": 42, "name": "Alice", "email": "alice@new.com"}, db_update_user)
async function writeThroughProduct(productId, data, dbUpdateFn) {
const cacheKey = `product:${productId}`;
// Actualizar base de datos
await dbUpdateFn(productId, data);
// Actualizar caché
await redis.setex(cacheKey, 300, JSON.stringify(data));
}Patrón Write-Behind (Write-Back)
El intercambio opuesto: la escritura llega a Redis al instante y un worker en segundo plano la vuelca a la base de datos en lotes. Las escrituras siguen rápidas incluso bajo ráfagas — pero cualquier cosa que esté en pending_writes cuando Redis muera se pierde. Úsalo para contadores, eventos y cualquier dato del que puedas perder un segundo.
import json
import redis
import threading
import time

r = redis.Redis(host="localhost", port=6379, decode_responses=True)

def write_behind_update(entity_type: str, entity_id: int, data: dict):
    """Escribir a caché inmediatamente, encolar para escritura async a DB."""
    cache_key = f"{entity_type}:{entity_id}"

    # Escribir a caché
    r.setex(cache_key, 300, json.dumps(data))

    # Encolar para persistencia async
    r.lpush("pending_writes", json.dumps({
        "type": entity_type,
        "id": entity_id,
        "data": data,
        "timestamp": int(time.time())
    }))

# Worker en background que procesa writes pendientes
def flush_pending_writes(db_write_fn, batch_size=100):
    while True:
        items = r.rpop("pending_writes", batch_size)
        if not items:
            threading.Event().wait(1)
            continue

        for item in items:
            entry = json.loads(item)
            try:
                db_write_fn(entry["type"], entry["id"], entry["data"])
            except Exception as e:
                # Re-encolar writes fallidos
                r.lpush("pending_writes", json.dumps(entry))
                print(f"Write failed: {e}")
Prevención de Cache Stampede con Locks
Cuando una key caliente expira bajo tráfico, cada petición concurrente ve el mismo miss y golpea la base de datos a la vez — el stampede que tiró tu DB probablemente era una key caliente, no carga real. Dos defensas: un lease lock para que exactamente una petición rellene la entrada mientras las demás esperan, y un refresco temprano probabilístico para que la entrada se reconstruya antes de expirar.
import json
import redis
import time
import random

r = redis.Redis(host="localhost", port=6379, decode_responses=True)

def get_with_stampede_protection(cache_key: str, fetcher, ttl: int = 300):
    """Prevenir cache stampede usando un lock Redis."""
    cached = r.get(cache_key)
    if cached:
        return json.loads(cached)

    lock_key = f"lock:{cache_key}"
    acquired = r.set(lock_key, "1", ex=10, nx=True)

    if acquired:
        try:
            result = fetcher()
            r.setex(cache_key, ttl, json.dumps(result))
            return result
        finally:
            r.delete(lock_key)
    else:
        time.sleep(0.1)
        return get_with_stampede_protection(cache_key, fetcher, ttl)

# Expiración temprana probabilística (reduce stampede sin locks)
def get_with_early_refresh(cache_key: str, fetcher, ttl: int = 300, early_refresh_pct: float = 0.1):
    cached = r.get(cache_key)
    if cached:
        ttl_remaining = r.ttl(cache_key)
        if ttl_remaining < ttl * early_refresh_pct and random.random() < 0.1:
            try:
                result = fetcher()
                r.setex(cache_key, ttl, json.dumps(result))
                return result
            except Exception:
                pass  # Servir stale si falla el refresh
        return json.loads(cached)

    result = fetcher()
    r.setex(cache_key, ttl, json.dumps(result))
    return result
Redis Pub/Sub para Invalidación entre Instancias
Cuando varias instancias de la app guardan sus propias copias cacheadas, borrar una key en una instancia deja obsoletas a las demás. Publica un evento de invalidación y deja que cada suscriptor limpie la misma key — escala mejor que las keys versionadas para datos compartidos que cambian a menudo.
const Redis = require("ioredis");
const pub = new Redis();
const sub = new Redis();

// Suscribirse al canal de invalidación
sub.subscribe("cache:invalidate");
sub.on("message", (channel, message) => {
  const { key } = JSON.parse(message);
  redis.del(key);
  console.log(`Invalidated: ${key}`);
});

// Publicar invalidación al actualizar datos
async function updateUser(userId, data) {
  await db.query("UPDATE users SET ... WHERE id = ?", [userId]);
  const cacheKey = `user:${userId}`;
  await redis.del(cacheKey);
  await pub.publish("cache:invalidate", JSON.stringify({ key: cacheKey }));
}
import redis
import json
r = redis.Redis(host="localhost", port=6379, decode_responses=True)
pubsub = r.pubsub()
# Suscriptor
pubsub.subscribe("cache:invalidate")
for message in pubsub.listen():
if message["type"] == "message":
data = json.loads(message["data"])
r.delete(data["key"])
# Publicador
def invalidate_cache(key: str):
r.delete(key)
r.publish("cache:invalidate", json.dumps({"key": key}))Scripts Lua para Operaciones Atómicas
INCR seguido de EXPIRE como dos llamadas corre una carrera bajo concurrencia — una segunda petición puede colarse en medio y la key se queda sin TTL. Un script Lua se ejecuta atómicamente dentro de Redis, así que el par siempre corre como una sola operación.
import redis

r = redis.Redis(host="localhost", port=6379)

# Rate limiter atómico usando Lua
RATE_LIMIT_SCRIPT = """
local current = redis.call('INCR', KEYS[1])
if current == 1 then
    redis.call('EXPIRE', KEYS[1], ARGV[1])
end
return current
"""

rate_limiter = r.register_script(RATE_LIMIT_SCRIPT)

def is_rate_limited(key: str, max_requests: int, window: int) -> bool:
    current = rate_limiter(keys=[key], args=[window])
    return current > max_requests

# Compare-and-swap atómico para caché
CAS_SCRIPT = """
local cached = redis.call('GET', KEYS[1])
if cached == ARGV[1] then
    redis.call('SET', KEYS[1], ARGV[2], 'EX', ARGV[3])
    return 1
end
return 0
"""

cas = r.register_script(CAS_SCRIPT)
Redis Sentinel para Alta Disponibilidad
En producción Redis no es un proceso único. Sentinel vigila el primario, hace failover a una réplica cuando muere y permite a los clientes descubrir qué nodo es el escribible en cada momento. Las lecturas también pueden repartirse a réplicas para descargar el primario.
from redis.sentinel import Sentinel

sentinel = Sentinel([
    ("sentinel1", 26379),
    ("sentinel2", 26379),
    ("sentinel3", 26379),
])

# Conexión al master
master = sentinel.master_for("mymaster", socket_timeout=0.5)

# Conexión a réplica para lecturas
replica = sentinel.slave_for("mymaster", socket_timeout=0.5)

# Escrituras van al master
master.set("key", "value")

# Lecturas pueden ir a la réplica
value = replica.get("key")
const Redis = require("ioredis");
// Cliente aware de Sentinel
const redis = new Redis({
sentinels: [
{ host: "sentinel1", port: 26379 },
{ host: "sentinel2", port: 26379 },
],
name: "mymaster",
role: "master",
});Lo que funciona
- Configura TTL en todo: Una entrada sin TTL vive para siempre — y también el dato obsoleto que contiene. Cinco a quince minutos para datos volátiles, horas para datos de referencia estables.
- Usa versionado de cache keys:
user:v2:123te permite retirar un esquema entero subiendo el prefijo de versión — sin invalidación explícita. - Serializa a JSON o MessagePack: JSON lo puedes leer en
redis-cli; MessagePack es más pequeño y rápido. Evitapicklede Python y la serialización nativa de Java — ambas ejecutan código al deserializar. - Maneja cache misses elegantemente: Un fallo de Redis debe degradar a la base de datos, nunca tumbar la app. Envuelve las conexiones en un circuit breaker.
- Monitorea hit rates: Por debajo de ~80 %, algo falla — o el TTL es muy corto para el patrón de acceso o estás cacheando datos que nadie vuelve a leer.
Errores Comunes
- Cache stampede: Una key caliente expira y doscientas peticiones concurrentes miss a la vez — directas a la base de datos. Usa expiración temprana probabilística o locks para prevenirlo.
- Caché sin TTL: El caché crece sin límite hasta que Redis empieza a expulsar keys — posiblemente las que te importaban.
- Almacenar objetos grandes: Un blob JSON de 10MB bloquea la conexión en cada lectura y escritura. Cachea fragmentos más pequeños y desnormalizados.
- No invalidar en escrituras: Actualiza el email de un usuario sin limpiar el perfil cacheado y la dirección vieja se sigue sirviendo mientras dure el TTL.
- Usar Redis como base de datos primaria: Es un almacén en memoria. Reinicia sin persistencia (AOF/RDB) configurada y se pierde todo — mantén la fuente de verdad en una base de datos real.
Lecturas Recomendadas
- Políticas de eviction de Redis — cómo elige Redis las keys a expulsar cuando se llena la memoria.
- Locks distribuidos con Redis — el patrón SET NX/EX detrás de la protección contra stampede.
- Estrategias de caching en AWS — referencia autorizada de los cuatro patrones de caché.
- Companion ejecutable — el decorador cache-aside, las defensas contra stampede y el helper ioredis listos para correr.
Tips de Rendimiento
- Usa
PIPELINEpara writes batch. Reduce round-trips de red por 10-100x:
pipe = r.pipeline(transaction=False)
for i in range(1000):
    pipe.setex(f"cache:{i}", 300, f"value:{i}")
pipe.execute()- Usa
HSET/HGETALLpara datos estructurados. Los hashes son más eficientes en memoria que keys string separadas para campos relacionados:
r.hset("user:42", mapping={"name": "Alice", "email": "alice@example.com", "role": "admin"})
user = r.hgetall("user:42")- Usa
ZSETpara datos ordenados. Los sorted sets permiten consultas eficientes de leaderboards y rankings:
r.zadd("leaderboard", {"alice": 1500, "bob": 1200, "carol": 2000})
top_10 = r.zrevrange("leaderboard", 0, 9, withscores=True)- Habilita
lazyfree-lazy-evictionpara keys grandes. Borrar keys grandes sincrónicamente bloquea Redis. Habilita lazy freeing:
# redis.conf
lazyfree-lazy-eviction yes
lazyfree-lazy-expire yes
lazyfree-lazy-server-del yes- Usa
EXPIREcon flagNX(Redis 7+). Establece expiración solo si la key no tiene TTL:
r.expire("user:42", 3600, nx=True) # Solo establece TTL si no existePreguntas frecuentes
¿Cómo prevengo el cache stampede?
Expiración temprana probabilística: Refresca el caché unos segundos antes de que expire el TTL, pero solo en una fracción de peticiones. Alternativamente, usa un lease lock: la primera petición que recibe un cache miss adquiere un lock, obtiene de la DB y actualiza el caché. Otras peticiones esperan o sirven datos ligeramente obsoletos.
¿Qué debo cachear y qué no?
Cachea: Perfiles de usuario, catálogos de productos, configuración, datos de referencia, agregados computados y resultados de consultas frecuentes.
No cachees: Datos que cambian rápidamente (precios de acciones, analytics en tiempo real), blobs grandes (videos, imágenes), o datos donde la consistencia es crítica y la DB puede manejar la carga.
¿Cómo invalido cachés entre múltiples instancias de app?
Usa Redis Pub/Sub o un prefijo de versión en cache keys. Cuando los datos cambian, publica un mensaje de invalidación a un canal Redis. Todas las instancias de la app se suscriben al canal y limpian sus cachés locales o remotos. Alternativamente, cambia un prefijo de versión (v1 → v2) en tus cache keys para invalidar silenciosamente entradas antiguas sin mensajería explícita.
¿Cuánto debería durar mi TTL?
Tan corto como la exigencia de frescura lo permita. Cinco a quince minutos funcionan para la mayoría de datos volátiles; horas o un día para datos de referencia que cambian poco. Si dudas, empieza en 10 minutos y revisa tu hit rate — por debajo de ~80 %, probablemente el TTL es demasiado corto o estás cacheando las keys equivocadas.
¿El caching sustituye a los índices de base de datos?
No. El caching enmascara consultas lentas; los índices las arreglan. Optimiza primero la consulta — un caché sobre una consulta rota esconde un problema que reaparece en cada miss.
Recursos Relacionados
Caché y Memoización en Python, JavaScript y Java
Cómo cachear computaciones costosas y respuestas de API usando caches en memoria, LRU, TTL y distribuidos en Python, JavaScript y Java.
RecipeCaché en Node.js con Redis: Cache-Aside, TTL e Invalidation
Implementa caché de respuestas API en Node.js con Redis e ioredis.
GuideEstrategias de Caching con Redis
caching con Redis: cache-aside, read-through, write-through, write-behind y refresh-ahead. Cubre politicas de eviction, tuning de TTL, serializacion y operaciones de produccion.
RecipeLimitación de Tasa (Rate Limiting)
Cómo implementar rate limiting en APIs usando token bucket, sliding window y fixed window en Python, JavaScript y Java.
RecipeCachear Resultados de Consultas de Base de Datos con
Cachear resultados de consultas costosas en Redis con patron cache-aside, gestion de TTL e invalidacion en writes para aplicaciones Python.
PatternPatrón Circuit Breaker en Python, JavaScript y Java
Previene fallos en cascada deteniendo solicitudes a servicios que están fallando. Un patrón arquitectural para sistemas distribuidos resilientes.