Plantilla de Documentación de Esquema de Base de Datos
Una plantilla para documentar esquemas de base de datos con relaciones entre entidades, definiciones de campos e historial de migraciones.
Resumen
Los esquemas de base de datos evolucionan constantemente. Sin documentación, cada desarrollador nuevo pierde horas descifrando relaciones entre tablas, adivinando por qué existe una columna y preguntándose si un índice sigue en uso. Esta plantilla te da una estructura para documentar esquemas que se mantiene útil a medida que la base de datos crece.
La plantilla cubre cuatro áreas:
- Documentación de entidades: propósito de cada tabla, definiciones de columnas, significado de negocio
- Mapeo de relaciones: claves foráneas, diagramas ER, reglas de borrado en cascada
- Estrategia de indexación: qué consulta sirve cada índice, cuándo se agregó y por qué
- Seguimiento de migraciones: versiones del esquema, historial de cambios, notas de reversión
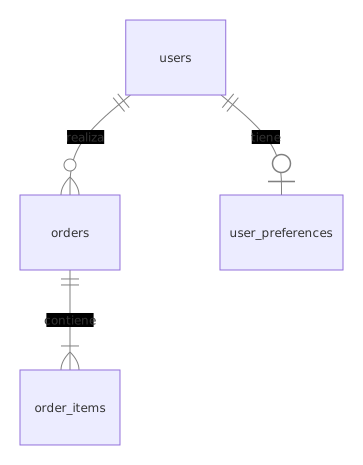
El ejemplo de abajo documenta un esquema pequeño de e-commerce. Así se ve como diagrama ER:
Combina esta plantilla con el Runbook de Migración de Bases de Datos para el seguimiento operativo de cambios.
Plantilla
# Documentación de Esquema: [Nombre de la Base de Datos]

## Resumen
- **Motor:** PostgreSQL 16 / MySQL 8 / etc.
- **Propósito:** Un párrafo que describe qué almacena esta base de datos y qué servicios leen y escriben en ella.
- **Equipo responsable:** [nombre del equipo]
- **Replicación:** [ninguna / streaming / lógica]
- **Copias de seguridad:** [diarias / por hora / continuas]

## Entidades

### Tabla: users

**Propósito:** Almacena las cuentas de usuario autenticadas de la aplicación.

| Columna | Tipo | Nullable | Default | Descripción |
|---------|------|----------|---------|-------------|
| id | uuid | NO | gen_random_uuid() | Clave primaria, generada en el servidor |
| email | varchar(255) | NO | — | Único, en minúsculas al insertar mediante trigger |
| password_hash | varchar(255) | NO | — | Hash Argon2id, nunca registrar ni exponer |
| display_name | varchar(100) | YES | NULL | Nombre elegido por el usuario, visible en la UI |
| status | smallint | NO | 1 | 0=borrado, 1=activo, 2=suspendido, 3=pendiente_verificación |
| metadata | jsonb | YES | '{}' | Almacén clave-valor flexible para flags de funcionalidad y preferencias |
| created_at | timestamptz | NO | now() | Marca de creación del registro |
| updated_at | timestamptz | NO | now() | Actualizada por trigger en cada UPDATE |
| deleted_at | timestamptz | YES | NULL | Marcador de borrado lógico; filtrado por las consultas de la aplicación |

**Restricciones:**
- `users_email_key` — UNIQUE sobre `email`
- `users_status_check` — CHECK (status >= 0 AND status <= 3)

**Índices:**
| Nombre | Columnas | Tipo | Propósito | Migración que lo agregó |
|--------|----------|------|-----------|------------------------|
| users_pkey | id | btree | Clave primaria | 001_initial |
| users_email_key | email | btree | Búsqueda de login, unicidad | 001_initial |
| users_status_idx | status | btree | Filtrar usuarios activos en el panel de administración | 014_admin_dashboard |
| users_created_at_idx | created_at | btree | Paginación por fecha de creación | 022_pagination |

**Reglas de negocio:**
- El email se convierte a minúsculas al insertar y actualizar mediante un trigger
- `status = 0` (borrado) lo establece la aplicación, nunca un UPDATE directo
- `metadata` no debe contener datos personales — lo valida la aplicación, no una restricción de la base de datos
- `deleted_at` se establece cuando status pasa a 0; ambos campos deben coincidir

### Tabla: orders

**Propósito:** Almacena los pedidos de clientes, vinculados al usuario que los realizó.

| Columna | Tipo | Nullable | Default | Descripción |
|---------|------|----------|---------|-------------|
| id | uuid | NO | gen_random_uuid() | Clave primaria |
| user_id | uuid | NO | — | FK a users.id, borrado en cascada |
| total_cents | integer | NO | 0 | Total en centavos, nunca float |
| currency | char(3) | NO | 'USD' | Código de moneda ISO 4217 |
| status | smallint | NO | 0 | 0=pendiente, 1=pagado, 2=enviado, 3=entregado, 4=cancelado, 5=reembolsado |
| placed_at | timestamptz | NO | now() | Cuándo se realizó el pedido |
| shipped_at | timestamptz | YES | NULL | Cuándo se envió el pedido |

**Restricciones:**
- `orders_user_id_fkey` — FOREIGN KEY (user_id) REFERENCES users(id) ON DELETE CASCADE
- `orders_total_check` — CHECK (total_cents >= 0)
- `orders_currency_check` — CHECK (currency IN ('USD', 'EUR', 'GBP', 'JPY'))

**Índices:**
| Nombre | Columnas | Tipo | Propósito | Migración que lo agregó |
|--------|----------|------|-----------|------------------------|
| orders_pkey | id | btree | Clave primaria | 001_initial |
| orders_user_id_idx | user_id | btree | Listar pedidos por usuario | 001_initial |
| orders_status_placed_at_idx | status, placed_at | btree | Panel de administración: filtrar por estado, ordenar por fecha | 014_admin_dashboard |

**Reglas de negocio:**
- `total_cents` se almacena como entero para evitar errores de punto flotante
- Los pedidos con `status >= 2` no se pueden cancelar (lo impone la aplicación)
- `shipped_at` debe ser null cuando `status < 2` (lo impone la aplicación)

## Relaciones

```
users 1───∞ orders
  │              │
  │              └── order_items (items por pedido)
  │
  └── user_preferences (1:1, opcional)
```

- **users → orders**: Un usuario puede tener muchos pedidos. El borrado en cascada elimina los pedidos cuando se borra un usuario definitivamente (raro; se prefiere el borrado lógico).
- **orders → order_items**: Un pedido tiene muchos items. Borrado en cascada.
- **users → user_preferences**: Uno a uno, LEFT JOIN. Las preferencias son opcionales.

## Referencia de Valores Enum

| Tabla | Columna | Valor | Significado |
|-------|---------|-------|-------------|
| users | status | 0 | Borrado (lógico) |
| users | status | 1 | Activo |
| users | status | 2 | Suspendido (acción de administración) |
| users | status | 3 | Pendiente de verificación de email |
| orders | status | 0 | Pendiente de pago |
| orders | status | 1 | Pagado, esperando envío |
| orders | status | 2 | Enviado |
| orders | status | 3 | Entregado |
| orders | status | 4 | Cancelado |
| orders | status | 5 | Reembolsado |

## Historial de Migraciones

| Versión | Fecha | Descripción | Autor | Notas de reversión |
|---------|-------|-------------|-------|--------------------|
| 001 | 2026-01-15 | Esquema inicial (users, orders, order_items) | Mathias | Eliminar todas las tablas |
| 014 | 2026-03-02 | Agregar índices del panel de administración | Mathias | DROP INDEX orders_status_placed_at_idx; DROP INDEX users_status_idx; |
| 022 | 2026-05-10 | Agregar índice de paginación en users.created_at | Mathias | DROP INDEX users_created_at_idx; |

## Columnas Obsoletas

| Tabla | Columna | Obsoleta desde | Eliminación prevista | Reemplazo |
|-------|---------|----------------|----------------------|-----------|
| users | legacy_id | 2026-04-01 | 2026-07-01 | Migrada a `id` (uuid) en la migración 018 |

## Notas

- Todas las marcas de tiempo se almacenan como `timestamptz` en UTC. La aplicación convierte a la zona horaria del usuario al mostrarlas.
- Los valores monetarios se almacenan como centavos enteros, nunca como float ni numeric.
- Los borrados lógicos usan `deleted_at` + `status = 0`. Los borrados físicos requieren una razón documentada y una migración.
- La columna `metadata` jsonb es solo para datos no estructurados. Si una clave empieza a consultarse con frecuencia, promuévela a columna real.
Lo que funciona
- Documenta cada tabla y columna: los desarrolladores futuros (tú incluido) te lo agradecerán. Combina los documentos del esquema con un Runbook de Migración para el seguimiento de cambios.
- Explica el significado de negocio, no solo los tipos:
statuses obvio; por qué existemetadatano lo es - Incluye el “por qué” de los índices: cada índice tiene un costo; documenta qué consulta sirve. Consulta la Guía de Optimización de SQL para la estrategia de indexación.
- Versiona la documentación del esquema: registra qué cambió y cuándo, igual que con el código
- Mantén el diagrama ER actualizado: una referencia visual es más rápida que leer SQL cuando estás aprendiendo el modelo
- Marca las columnas obsoletas: no borres la documentación de columnas eliminadas de inmediato; márcalas como obsoletas con una fecha de eliminación
- Documenta los valores enum en una tabla de referencia: números mágicos como
status = 3no significan nada sin contexto - Registra notas de reversión en cada migración: cuando un despliegue falla, hay que revertir rápido
Errores comunes
- Documentar el esquema una vez y no volver a actualizarlo: la documentación obsoleta es peor que no tener ninguna
- Documentar solo las tablas e ignorar índices y restricciones: los índices revelan patrones de consulta
- Usar nombres de columna vagos sin explicación:
dataovalueno dicen nada - No documentar el patrón de borrado lógico: los desarrolladores nuevos suelen olvidar los filtros de
deleted_at - Olvidar documentar los valores enum: ¿qué significa
status = 3? - Almacenar dinero como float: usa centavos enteros o un tipo decimal dedicado
- No documentar las reglas de cascada:
ON DELETE CASCADEpuede borrar datos silenciosamente - Mezclar marcas de tiempo UTC y locales: elige una (UTC) y aplícala con
timestamptz - Omitir la sección de “reglas de negocio”: las restricciones SQL no capturan las reglas a nivel de aplicación
- Copiar la plantilla tal cual: elimina las secciones que no aplican a tu esquema en lugar de dejar placeholders vacíos
Variantes
| Variante | Contexto | Enfoque | Notas |
|---|---|---|---|
| Generada automáticamente (tbls/dbdocs) | Esquema grande, cambios frecuentes | Extraer el DDL, generar diagramas | Añadir documentación narrativa encima |
| Markdown en el repositorio | Equipo pequeño, cambios vía PR | Documentos junto al código | La revisión de PR mantiene el sync |
| Wiki/Confluence | Organización con wiki existente | Adaptar las secciones a páginas wiki | Enlazar migraciones y postmortems |
| DBML/ERD visual | Onboarding rápido, stakeholders | Diagrama visual + documentos mínimos | Actualizar en cada migración |
Documentación generada automáticamente (tbls / dbdocs)
Herramientas como tbls y dbdocs generan documentación del esquema desde la base de datos en vivo. Producen diagramas ER, listados de columnas y resúmenes de restricciones automáticamente. Úsalas para la base estructural y añade encima la documentación narrativa (reglas de negocio, significado de los enums, razón de cada índice) — la documentación generada no puede decirte por qué existe una columna.
Markdown en el repositorio
Mantén la documentación del esquema como archivos Markdown en el mismo repositorio que el código de la aplicación. Así se revisa en los PRs junto con los cambios del esquema y no puede desactualizarse en silencio. Usa la plantilla de arriba como punto de partida.
Wiki / Confluence
En organizaciones con infraestructura wiki existente, adapta las secciones de la plantilla a páginas wiki. Enlaza cada tabla con su historial de migraciones y con los postmortems correspondientes.
Herramientas DBML / ERD
dbml.dbdiagram.io permite definir el esquema en DBML y renderiza el diagrama ER a la par. Es útil cuando los stakeholders necesitan más el visual que la prosa — pero guarda las secciones narrativas en algún lado, o terminarás con un diagrama que nadie sabe interpretar.
Escenario detallado: documentar una migración de esquema
Sistema: Base de datos de pedidos (PostgreSQL 16)
Cambio: Agregar la columna shipping_address_id a orders
Migración: 023_add_shipping_address

Paso 1 - Escribir la migración:
  -- 023_add_shipping_address.sql
  ALTER TABLE orders ADD COLUMN shipping_address_id uuid;
  ALTER TABLE orders ADD CONSTRAINT orders_shipping_address_id_fkey
    FOREIGN KEY (shipping_address_id) REFERENCES addresses(id)
    ON DELETE SET NULL;

  CREATE INDEX orders_shipping_address_id_idx
    ON orders(shipping_address_id)
    WHERE shipping_address_id IS NOT NULL;

Paso 2 - Actualizar la documentación del esquema:
  Tabla: orders
  | Columna | Tipo | Nullable | Default | Descripción |
  |---------|------|----------|---------|-------------|
  | shipping_address_id | uuid | YES | NULL | FK a addresses.id, SET NULL al borrar |

  Índices:
  | orders_shipping_address_id_idx | shipping_address_id | btree | Buscar pedidos por dirección | 023_add_shipping_address |

  Restricciones:
  | orders_shipping_address_id_fkey | FK (shipping_address_id) REFERENCES addresses(id) ON DELETE SET NULL |

Paso 3 - Actualizar el historial de migraciones:
  | 023 | 2026-07-11 | Agregar shipping_address_id a orders | Mathias | ALTER TABLE orders DROP COLUMN shipping_address_id; |

Paso 4 - Actualizar el diagrama ER:
  orders --- addresses (N:1, SET NULL al borrar)

Paso 5 - Notas de reversión:
  - La columna es nullable, no rompe consultas existentes
  - Reversión: DROP COLUMN (el índice y la FK se eliminan en cascada)
  - Datos: la columna se pierde, pero es derivable de order_items

Paso 6 - Comunicar al equipo:
  - PR con la migración + documentación actualizada
  - Nota en Slack: "Nueva columna shipping_address_id en orders"
  - Actualizar los modelos del ORM (Prisma, TypeORM, SQLAlchemy)
Lectura adicional
- Companion descargable — la plantilla como archivo Markdown listo para rellenar, más una versión DBML del esquema de ejemplo
- tbls — generador de documentación de bases de datos para CI
- dbdocs — documentación de bases de datos construida sobre DBML
- Especificación DBML — lenguaje de marcado para bases de datos
- PostgreSQL COMMENT — documentar objetos dentro de la base de datos
Preguntas frecuentes
¿Conviene generar la documentación del esquema automáticamente?
Sí, para la base estructural. Herramientas como tbls, dbdocs o los comentarios de pg_dump son un buen punto de partida y nunca quedan desactualizadas. Pero hay que añadir siempre documentación narrativa — el "por qué" detrás de las decisiones de diseño no se puede extraer del DDL.
¿Cómo mantengo la documentación sincronizada con la base de datos?
Genera las partes estructurales automáticamente en CI. Reserva las secciones manuales (significado de negocio, razón de los índices) para curación humana. Revisa la documentación en el mismo PR que cambia el esquema y añade un chequeo de CI que falle si existe un archivo de migración sin su actualización de documentación.
¿Cómo documento columnas calculadas o virtuales?
Documenta la fórmula o la lógica de cálculo en la sección de reglas de negocio de la tabla, e indica si la columna está almacenada o se calcula al leer. Para las columnas generadas de PostgreSQL (GENERATED ALWAYS AS), incluye la expresión SQL y señala que no se puede escribir directamente en ella.
¿Qué hago cuando una tabla tiene más de 50 columnas?
Divide la documentación por grupos lógicos de columnas. En una tabla users, por ejemplo: autenticación (email, password_hash, status), perfil (display_name, avatar_url) y metadatos (jsonb, marcas de tiempo). La documentación queda legible sin perder completitud.
¿Qué nivel de detalle es demasiado?
Documenta cualquier cosa que confundiría a un miembro nuevo del equipo o que ya hayas explicado más de dos veces en Slack. Omite nombres autoexplicativos como id en una clave primaria, salvo que haya un default o una regla de generación no obvia.
¿Debería documentar cada índice?
Sí. Cada índice tiene un costo — almacenamiento y latencia de escritura. Si no puedes explicar por qué existe un índice, es candidato a eliminarse. Documenta la migración que lo agregó y el patrón de consulta que sirve.
¿Cómo documento vistas y vistas materializadas?
Trata las vistas como tablas. Para cada una, documenta las tablas subyacentes, la lógica de la consulta, si está materializada y su calendario de actualización. Las vistas materializadas también necesitan su estrategia de refresco (manual, programada, basada en triggers).
¿Y los procedimientos almacenados y funciones?
Documéntalos en una sección de API separada dentro de la documentación del esquema. Para cada función: nombre, parámetros, tipo de retorno, propósito y efectos secundarios (escrituras, notificaciones, etc.). Si una función es llamada desde el código de la aplicación, enlaza al servicio que la invoca.
¿Cómo manejo los cambios de esquema en ramas de funcionalidad?
Documenta el esquema base con normalidad. Para las ramas que agregan tablas o columnas, añade una sección "Cambios de esquema en rama" listando los objetos temporales y su plan de limpieza. Cuando la funcionalidad se fusiona, traslada los cambios a la documentación principal y elimina la sección de la rama.
Recursos Relacionados
Plantilla de Runbook de Migración de Base de Datos
Plantilla de runbook de migración de base de datos para ejecutar cambios de esquema de forma segura con procedimientos de rollback, pasos de verificación y planes de comunicación.
DocPlantilla de Diagramas de Sistema
Una plantilla para crear diagramas de arquitectura siguiendo el modelo C4.
DocPlantilla de Especificación Técnica
Usa esta plantilla de especificación técnica para documentar requisitos, decisiones de diseño, arquitectura, contratos de API y criterios de aceptación.
GuideGuía de Diseño de Bases de Datos
Guía práctica para diseñar bases de datos relacionales con normalización, indexación y modelado de relaciones.
GuideOptimización de Rendimiento SQL
Una guía práctica para optimizar consultas SQL: estrategias de indexación, reescritura de queries, análisis de EXPLAIN plans y anti-patrones comunes a evitar.
RecipeMigración de columnas sin downtime
Renombra columnas o cambia tipos de datos sin bloquear tablas usando vistas, triggers y estrategias de relleno incremental.