Guía Completa de Comunicación entre Microservicios
Compara patrones de comunicación síncrona vs asíncrona para microservicios. Cubre REST, gRPC, colas de mensajes, event-driven, service mesh y cuándo usar cada uno.
Introducción
Dividir un monolito en servicios traslada tus llamadas a funciones a la red. Ese único cambio — de una invocación dentro del proceso a una llamada remota — es donde la mayoría de los proyectos de microservicios ganan o pierden. Llamadas que antes tardaban microsegundos ahora tardan milisegundos, pueden agotar el tiempo de espera, pueden reintentarse y pueden duplicar trabajo del otro lado sin que nadie lo note.
El patrón de comunicación que elijas para cada salto decide cómo se acumula la latencia, qué ocurre cuando una dependencia está caída, cuánto se acoplan los servicios y qué tan doloroso es operar el sistema a las 3 de la mañana. Esta guía compara los patrones síncronos (REST, gRPC), los asíncronos (colas de mensajes, pub/sub, el patrón outbox) y la capa de infraestructura (API gateway, service mesh), con código funcional y criterios de decisión para cada uno. Asume que ya ejecutas dos o más servicios y necesitas conectarlos — si todavía estás decidiendo si los microservicios son para tu sistema, empieza por la guía de arquitectura de microservicios. Todo el código de esta guía está también disponible como archivos independientes en el repositorio companion.
Síncrono vs Asíncrono
Una llamada síncrona es una llamada a función remota: el emisor envía una petición, se bloquea y espera la respuesta. Una interacción asíncrona entrega un mensaje a un broker y sigue adelante — el trabajo ocurre después, posiblemente en un servicio que el emisor ni siquiera conoce.
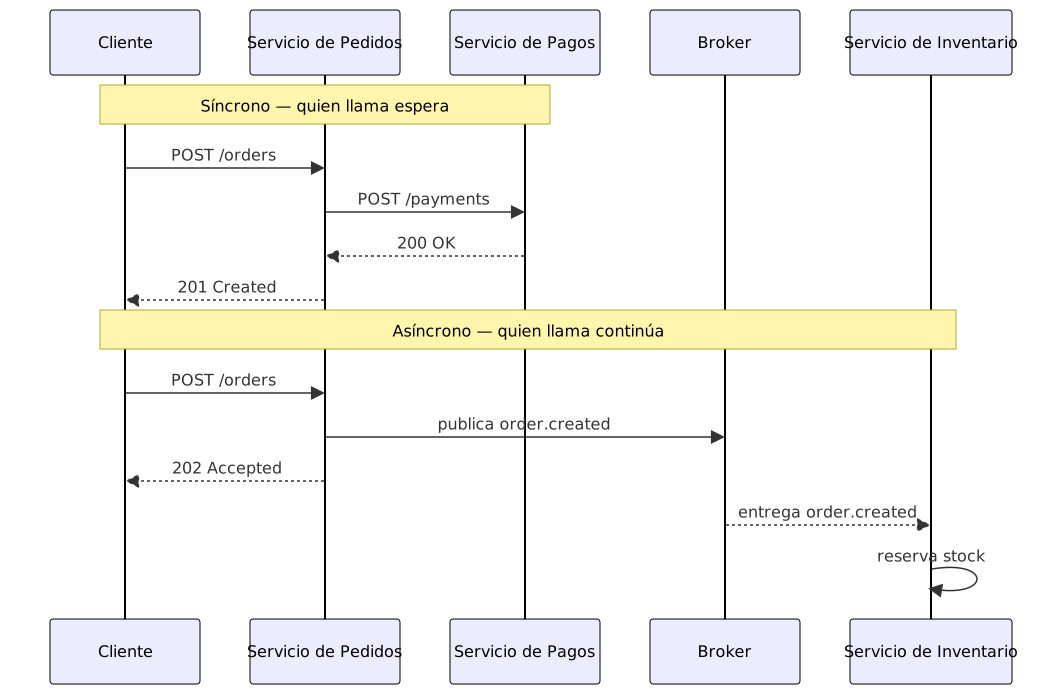
| Aspecto | Síncrono | Asíncrono |
|---|---|---|
| Acoplamiento | Fuerte (quien llama conoce al receptor) | Débil (quien llama no conoce al receptor) |
| Latencia | Quien llama espera la respuesta | Quien llama continúa de inmediato |
| Fallo | Quien llama falla si el receptor está caído | El mensaje persiste, el receptor procesa después |
| Escalabilidad | Limitada por el servicio más lento | Mejor — los servicios escalan de forma independiente |
| Complejidad | Más simple de implementar | Requiere broker, idempotencia y orden |
| Caso de uso | Lecturas frecuentes, baja latencia | Escrituras frecuentes, flujos desacoplados |
La tabla esconde dos costos que pegan fuerte en producción. Del lado síncrono, la latencia se acumula: si una petición se ramifica a tres servicios en serie y cada uno añade ~80 ms, el emisor espera 240 ms más el overhead de red antes de hacer su propio trabajo. La disponibilidad también se acumula — encadena cinco llamadas al 99,9% de uptime cada una y la cadena entrega aproximadamente 99,5%. Del lado asíncrono, cambias esos costos por otros nuevos: la entrega at-least-once implica procesamiento duplicado salvo que los consumidores sean idempotentes, el orden solo está garantizado por partición, y “¿funcionó?” deja de ser un código de estado para convertirse en una pregunta que respondes con correlation IDs y monitoreo.
Ningún estilo es el default. Lo síncrono es la opción correcta para lecturas y flujos petición/respuesta donde el cliente realmente necesita la respuesta ya — una consulta de precio, una verificación de autenticación. Lo asíncrono justifica su complejidad cuando el trabajo puede diferirse, cuando varias partes reaccionan al mismo evento, o cuando no puedes permitir que la caída de un servicio ajeno se convierta en tu caída.
La Trampa del Monolito Distribuido
El fallo de comunicación más común no es elegir el protocolo equivocado — es reconstruir el grafo de llamadas del monolito sobre HTTP. Terminas con servicios que no pueden desplegarse, escalarse ni reiniciarse de forma independiente porque cada petición atraviesa cinco de ellos.
La señal es fácil de detectar: una sola acción del usuario dispara una cadena como Pedido → Inventario → Precios → Promociones → Envíos, cada llamada síncrona, cada una un nuevo punto de fallo y un nuevo salto de latencia. Los servicios parecen independientes en el grafo del repo pero se comportan como un único proceso frágil. Despliega un cambio en Precios y tendrás que redesplegar Pedido igualmente, porque los contract tests de Pedido dependen de él.
La solución no es “hacerlo todo asíncrono”. Es eliminar saltos que no necesitan existir:
- Cachea o replica datos de lectura. Si Pedido necesita el nombre del producto para sus respuestas de API, no debería llamar a Catálogo en cada lectura — desnormaliza el campo o suscríbete a un evento
catalog.updatedy mantén una copia local. - Saca trabajo del camino de la petición. Enviar un email de confirmación o reservar inventario no necesita terminar antes de que el cliente reciba su 201. Publica un evento y deja que los workers avancen.
- Fusiona servicios demasiado granulares. Dos servicios que siempre cambian juntos y siempre se llaman entre sí quizá son un solo servicio que se dividió demasiado pronto.
Cada salto síncrono que eliminas mejora latencia, disponibilidad y capacidad de despliegue al mismo tiempo. Cuando un salto debe seguir siendo síncrono, protégelo con timeouts, reintentos y un circuit breaker — cubierto en la sección de resiliencia más abajo.
Patrones Síncronos
REST (HTTP/JSON)
from fastapi import FastAPI, HTTPException
import httpx

app = FastAPI()

ORDER_SERVICE = "http://order-service:8000"
PAYMENT_SERVICE = "http://payment-service:8000"

@app.get("/orders/{order_id}/summary")
async def order_summary(order_id: str):
    async with httpx.AsyncClient(timeout=5.0) as client:
        try:
            order = await client.get(f"{ORDER_SERVICE}/orders/{order_id}")
            order.raise_for_status()
            payment = await client.get(f"{PAYMENT_SERVICE}/payments/{order_id}")
            payment.raise_for_status()
        except httpx.HTTPError as e:
            raise HTTPException(status_code=502, detail=f"Upstream error: {e}")

    return {
        "order": order.json(),
        "payment": payment.json(),
    }
REST sigue siendo el default porque se depura solo: puedes hacer curl a un endpoint, leer el payload y reproducir un bug desde un ticket sin herramientas. Los trade-offs son el tamaño del payload (JSON es verboso), el head-of-line blocking en HTTP/1.1 y la ausencia de contrato integrado — el consumidor se entera de un cambio rompedor cuando las llamadas de producción empiezan a fallar.
Dos detalles de este ejemplo importan más de lo que parece. El timeout=5.0 no es decoración opcional — sin él un servicio de pagos colgado retiene tu conexión (y tu hilo o coroutine) para siempre. Y ambas consultas ocurren dentro de un mismo cliente, así que pueden ejecutarse en paralelo si las refactorizas con asyncio.gather; la versión secuencial mostrada aquí es el caso simple, no el rápido.
Cuándo usar REST:
- APIs públicas, integraciones externas
- Operaciones CRUD
- Payloads legibles por humanos
- Endpoints orientados a navegadores
Cuándo evitarlo: llamadas internas de alta frecuencia donde la serialización domina la CPU, o cualquier cosa que necesite streaming — eso es territorio de gRPC.
gRPC (HTTP/2 + Protobuf)
syntax = "proto3";

service OrderService {
  rpc GetOrder (OrderRequest) returns (OrderResponse);
  rpc CreateOrder (CreateOrderRequest) returns (OrderResponse);
}

message OrderRequest {
  string order_id = 1;
}

message OrderResponse {
  string order_id = 1;
  string status = 2;
  double total = 3;
}
import grpc
import order_pb2
import order_pb2_grpc
def get_order(order_id: str) -> order_pb2.OrderResponse:
with grpc.insecure_channel("order-service:50051") as channel:
stub = order_pb2_grpc.OrderServiceStub(channel)
return stub.GetOrder(order_pb2.OrderRequest(order_id=order_id))gRPC cambia la legibilidad de REST por velocidad y garantías. Los payloads Protobuf son binarios compactos, HTTP/2 multiplexa llamadas sobre una conexión, y el archivo .proto es un contrato versionado — los números de campo hacen explícita la evolución del esquema en lugar de “esperar que nadie renombre una clave JSON”. El streaming (de servidor, de cliente o bidireccional) es una característica de primera clase, algo que REST no puede expresar en absoluto.
Los costos: los navegadores no hablan gRPC de forma nativa (necesitarías gRPC-Web o un gateway), los payloads no son legibles sin un decodificador, y el paso de generación de stubs añade fricción a equipos políglotas. Los deadlines son tu equivalente a los timeouts — configúralos en cada llamada, porque gRPC propaga la cancelación por la cadena y un deadline ausente arriba significa trabajo desperdiciado hasta abajo.
Cuándo usar gRPC:
- Comunicación interna entre servicios
- Requisitos de alto rendimiento y baja latencia
- Tipado fuerte entre lenguajes
- Streaming (bidireccional, de servidor)
Para una guía más profunda, consulta gRPC en Microservicios — Guía de RPC de Alto Rendimiento.
Patrones Asíncronos
Cola de Mensajes (Punto a Punto)
import pika
import json

connection = pika.BlockingConnection(pika.ConnectionParameters("rabbitmq"))
channel = connection.channel()
channel.queue_declare(queue="order_created", durable=True)

# Productor — el servicio de pedidos publica un mensaje
def publish_order_created(order_id: str, customer_id: str):
    message = json.dumps({"order_id": order_id, "customer_id": customer_id})
    channel.basic_publish(
        exchange="",
        routing_key="order_created",
        body=message,
        properties=pika.BasicProperties(delivery_mode=2),  # persistente
    )

# Consumidor — el servicio de envíos procesa el mensaje
def consume_orders():
    def callback(ch, method, properties, body):
        order = json.loads(body)
        print(f"Enviando pedido {order['order_id']}")
        ch.basic_ack(delivery_tag=method.delivery_tag)

    channel.basic_consume(queue="order_created", on_message_callback=callback)
    channel.start_consuming()
Una cola es distribución de trabajo: cada mensaje llega exactamente a un consumidor, incluso cuando varios compiten por él. Es la forma correcta para “esta tarea debe ocurrir una vez” — cobrar una tarjeta, generar un PDF, redimensionar una imagen.
Los detalles que te mantienen fuera de problemas viven en los flags. durable=True en la cola más delivery_mode=2 en el mensaje hace que RabbitMQ escriba el mensaje en disco, así que sobrevive a un reinicio del broker. basic_ack después de procesar — no al recibir — significa que un consumidor que cae a mitad de tarea recibe el mensaje reenviado en lugar de perderlo. La otra cara: el reenvío implica que tu callback se ejecutará dos veces ante mensajes envenenados y handlers inestables, así que el trabajo del consumidor debe ser seguro de repetir.
Cuándo usar una cola: descarga de tareas, nivelación de carga ante tráfico con picos, e integraciones donde el productor no debe esperar. Cuando varios servicios necesitan el mismo hecho — no la misma tarea — lo que quieres es pub/sub.
Event-Driven (Pub/Sub)
const { Kafka } = require("kafkajs");

const kafka = new Kafka({
    clientId: "order-service",
    brokers: ["kafka:9092"],
});

const producer = kafka.producer();
const consumer = kafka.consumer({ groupId: "inventory-group" });

// Productor — publica eventos de dominio
async function publishOrderCreated(order) {
    await producer.connect();
    await producer.send({
        topic: "order.created",
        messages: [
            {
                key: order.id,
                value: JSON.stringify({
                    orderId: order.id,
                    customerId: order.customerId,
                    items: order.items,
                    timestamp: Date.now(),
                }),
            },
        ],
    });
    await producer.disconnect();
}

// Consumidor — varios servicios se suscriben al mismo evento
async function consumeOrderEvents() {
    await consumer.connect();
    await consumer.subscribe({ topic: "order.created", fromBeginning: false });

    await consumer.run({
        eachMessage: async ({ topic, partition, message }) => {
            const event = JSON.parse(message.value.toString());
            console.log(`Reservando inventario para el pedido ${event.orderId}`);
            // Actualizar inventario, luego publicar el evento inventory.reserved
        },
    });
}

consumeOrderEvents();
Pub/sub invierte la dependencia: el productor anuncia un hecho (order.created) y no sabe ni le importa quién reacciona. Inventario, envíos y analítica se suscriben cada uno con su propio consumer group y procesan el mismo evento de forma independiente — puedes añadir un consumidor nuevo sin tocar el productor, que es la razón de ser del diseño orientado a eventos.
Dos mecanismos de este fragmento cargan la semántica. El key: order.id enruta todos los eventos de un pedido a la misma partición, y el orden solo está garantizado dentro de una partición — elige una clave que agrupe las entidades cuyo orden importa. El groupId define el límite de consumidores competidores: dos instancias en inventory-group se reparten las particiones, mientras que un segundo grupo recibe su propia copia independiente del stream.
El precio que pagas es consistencia eventual — la siguiente sección cubre lo que eso significa en la práctica. Para el catálogo completo de patrones, consulta la guía de arquitectura orientada a eventos.
Event-Driven con Patrón Outbox (Java)
import org.springframework.stereotype.Service;
import org.springframework.transaction.annotation.Transactional;
import org.springframework.jdbc.core.JdbcTemplate;

@Service
public class OrderService {

    private final JdbcTemplate jdbc;

    public OrderService(JdbcTemplate jdbc) {
        this.jdbc = jdbc;
    }

    @Transactional
    public void createOrder(Order order) {
        // 1. Guardar el pedido
        jdbc.update(
            "INSERT INTO orders (id, customer_id, total) VALUES (?, ?, ?)",
            order.getId(), order.getCustomerId(), order.getTotal()
        );

        // 2. Guardar el evento outbox en la misma transacción
        jdbc.update(
            "INSERT INTO outbox (aggregate_id, event_type, payload) VALUES (?, ?, ?)",
            order.getId(), "OrderCreated", order.toJson()
        );
    }
}

// Un proceso separado lee el outbox y publica a Kafka
@Service
public class OutboxPublisher {

    private final JdbcTemplate jdbc;
    private final KafkaTemplate<String, String> kafka;

    public OutboxPublisher(JdbcTemplate jdbc, KafkaTemplate<String, String> kafka) {
        this.jdbc = jdbc;
        this.kafka = kafka;
    }

    @Scheduled(fixedDelay = 1000)
    public void publishPendingEvents() {
        var events = jdbc.queryForList(
            "SELECT id, aggregate_id, event_type, payload FROM outbox WHERE published = false LIMIT 100"
        );

        for (var event : events) {
            kafka.send("order." + event.get("event_type"),
                       (String) event.get("aggregate_id"),
                       (String) event.get("payload"));
            jdbc.update("UPDATE outbox SET published = true WHERE id = ?", event.get("id"));
        }
    }
}
El problema que esto resuelve es la doble escritura: “INSERT pedido, luego publicar evento” son dos escrituras en dos sistemas, y cualquier caída entre ellas deja la base de datos confirmada pero el evento perdido — o peor, el evento enviado pero la transacción revertida. El patrón transactional outbox lo corrige haciendo que el evento forme parte de la misma transacción de base de datos que la escritura de negocio. Un relevo — el publicador programado de aquí, o una herramienta CDC como Debezium en producción — lee la tabla outbox y reenvía al broker.
Una limitación honesta: este publicador marca las filas como enviadas después de kafka.send, así que una caída entre el envío y el update republica el evento. Los consumidores siguen necesitando idempotencia — el outbox te da at-least-once, no exactly-once.
Modelos de Consistencia y Sagas
Las llamadas síncronas te dan consistencia fuerte gratis — la respuesta es la verdad en ese momento. Los eventos te dan consistencia eventual: después de publicar order.created, cada consumidor converge al nuevo estado a su propio ritmo, y durante una ventana de tiempo distintos servicios están en desacuerdo sobre la realidad. Eso no es un bug a corregir; es el trato que firmaste. El error es fingir lo contrario — por ejemplo, escribir código que publica un evento y luego lee inmediatamente el servicio de destino esperando el resultado.
¿Qué haces cuando un proceso de negocio abarca varios servicios y debe completarse o deshacerse? Una saga: una secuencia de transacciones locales donde cada paso publica el evento que dispara el siguiente, y cada uno tiene una acción compensatoria que lo deshace si un paso posterior falla.
| Estilo | Cómo funciona | Encaja cuando |
|---|---|---|
| Coreografía | Los servicios reaccionan a los eventos de los demás — sin coordinador central | Pocos pasos (2–4), equipos débilmente acoplados |
| Orquestación | Un servicio coordinador indica a cada participante qué hacer después | Muchos pasos, necesitas visibilidad del estado del proceso |
Las sagas coreografiadas emergen naturalmente del pub/sub — Pedido publica order.created, Inventario reserva stock y publica inventory.reserved, Pagos cobra y publica payment.completed. La trampa es que nadie es dueño del flujo: cuando un reembolso falla tres saltos adentro, reconstruir “¿dónde está este pedido?” significa rastrear eventos a través de servicios. La orquestación te cuesta un componente coordinador, pero el estado del proceso vive en un solo lugar y es consultable. Empieza con coreografía; pasa a orquestación (Temporal, Camunda, una máquina de estados simple en tu servicio de pedidos) cuando soporte empiece a preguntar “¿en qué paso está atascado este pedido?” y no puedas responder.
Resiliencia: Timeouts, Reintentos e Idempotencia
Cada llamada síncrona necesita las tres cosas, y la mayoría de los incidentes de producción vienen de tener solo una.
- Los timeouts acotan la espera. Elígelos a partir del p99 real del receptor, no por intuición — si pagos responde en 300 ms p99, un timeout de 5 s es generoso, no ajustado.
- Los reintentos absorben fallos transitorios — una conexión TCP caída, una elección de líder. Reintenta con backoff exponencial y jitter, y limita los intentos (2–3); más allá de eso eres una tormenta de reintentos multiplicando la carga sobre un servicio que ya se está muriendo.
- La idempotencia hace seguros los reintentos. Un
POST /paymentsreintentado tras un timeout puede haber tenido éxito la primera vez — sin una clave de idempotencia, el cliente paga dos veces.
import httpx
import uuid

def charge_payment(order_id: str, amount: int, idempotency_key: str | None = None):
    key = idempotency_key or str(uuid.uuid4())
    response = httpx.post(
        "http://payment-service:8000/payments",
        json={"order_id": order_id, "amount": amount},
        headers={"Idempotency-Key": key},
        timeout=httpx.Timeout(5.0, connect=2.0),
    )
    response.raise_for_status()
    return response.json()
El servidor almacena la clave junto al resultado; una clave duplicada devuelve la respuesta original en lugar de re-ejecutar. GET, PUT y DELETE son idempotentes por semántica HTTP — POST no lo es, y es justamente POST el que mueve dinero y stock.
Los reintentos solos no bastan para una dependencia que está realmente caída — para eso existe el patrón circuit breaker: tras N fallos consecutivos deja de llamar, falla rápido y sondea la recuperación en lugar de encolar peticiones condenadas detrás de timeouts. El lado asíncrono tiene su propia versión de este contrato: consumidores idempotentes claveados por ID de evento, dead-letter queues para mensajes envenenados, y alertas de rezago del consumidor para que lo notes antes de que la cola tenga días de atraso.
Patrones de Infraestructura
API Gateway
# Configuración de Kong o NGINX API Gateway
apiVersion: v1
kind: ConfigMap
metadata:
  name: gateway-routes
data:
  kong.yml: |
    routes:
      - name: order-service
        paths:
          - /orders
        service:
          name: order-service
          url: http://order-service:8000
      - name: payment-service
        paths:
          - /payments
        service:
          name: payment-service
          url: http://payment-service:8000
    plugins:
      - name: rate-limiting
        config:
          minute: 100
      - name: jwt
El gateway es dueño de la frontera norte-sur: todo lo que el tráfico externo necesita — enrutado, autenticación, rate limiting, límites de tamaño de petición, terminación TLS — ocurre una sola vez, en el borde, en lugar de reimplementarse en cada servicio. También te da un único lugar para versionar APIs y deprecar rutas.
Dos advertencias. Primero, mantén la lógica de negocio fuera del gateway — en el momento en que un plugin de ruta codifica “si el total del pedido > 500 requiere aprobación”, has construido un servicio cuello de botella que nadie puede probar. Segundo, un gateway es un dominio de fallo compartido: cuando cae, todo cae. Ejecútalo replicado y mantén su configuración aburrida. Consulta la guía de diseño de API gateway para los patrones de resiliencia.
Service Mesh (Istio)
apiVersion: networking.istio.io/v1
kind: VirtualService
metadata:
  name: order-service
spec:
  hosts:
    - order-service
  http:
    - route:
        - destination:
            host: order-service
            subset: v1
            port:
              number: 8000
          weight: 90
        - destination:
            host: order-service
            subset: v2
            port:
              number: 8000
          weight: 10
---
apiVersion: networking.istio.io/v1
kind: DestinationRule
metadata:
  name: order-service
spec:
  host: order-service
  subsets:
    - name: v1
      labels:
        version: v1
    - name: v2
      labels:
        version: v2
  trafficPolicy:
    outlierDetection:
      consecutive5xxErrors: 5
      interval: 30s
      baseEjectionTime: 30s
Un mesh gestiona el tráfico este-oeste — las llamadas entre servicios dentro de tu cluster. Un proxy sidecar junto a cada servicio se hace cargo de mTLS, reintentos, timeouts, circuit breaking, telemetría y división de tráfico, así que el código de aplicación deja de reimplementarlos (normalmente de forma inconsistente, en cinco lenguajes). La configuración mostrada hace un canary 90/10 y expulsa pods que devuelven cinco respuestas 5xx consecutivas — ambas son unas líneas de YAML que de otro modo serían una integración de librería por servicio.
El costo honesto: los meshes añaden una capa operativa (control plane, actualizaciones de proxy, una nueva superficie de depuración) y 1–5 ms por salto. Están justificados cuando tienes suficientes servicios como para que las librerías de resiliencia por lenguaje se convirtieran en un problema de mantenimiento — por debajo de ese umbral, un cliente HTTP compartido o una librería como resilience4j cubre la mayor parte. La documentación de Istio es la referencia de lo que realmente es configurable.
Descubrimiento de Servicios
Ambos patrones anteriores asumen que quien llama puede encontrar al receptor — pero en una plataforma de contenedores, order-service no es una máquina, es un conjunto cambiante de pods. Opciones en orden aproximado de complejidad: DNS de Kubernetes (order-service.default.svc resuelve a endpoints saludables — gratis, sin infraestructura extra), un balanceador del lado del broker (el mesh lo gestiona), o un registro del lado del cliente como Consul o Eureka para entornos sin Kubernetes. En Kubernetes casi nunca necesitas descubrimiento a nivel de aplicación; buscar Consul dentro de un cluster suele ser pagar dos veces por lo mismo.
Cuándo No Usar Cada Patrón
Tan importante como las listas de “cuándo usar”:
- No uses asíncrono para un CRUD simple. Si el cliente necesita el registro guardado para renderizar una página, una cola te compra un
202 Acceptedmás un problema de polling. - No adoptes gRPC para APIs públicas o de navegador. REST con JSON es el default interoperable; gRPC-Web funciona pero añade una capa de proxy que depurar.
- No despliegues un service mesh con cinco servicios. El overhead operativo supera a las librerías de resiliencia por lenguaje hasta que la flota es lo bastante grande para que la consistencia sea el dolor real.
- No pongas un API gateway entre servicios internos. El tráfico este-oeste va por el mesh o llamadas directas; enrutar cada salto interno por un componente de borde añade latencia y un punto de fallo compartido.
- No coreografíes una saga de doce pasos. Pasado un puñado de pasos, la lógica del flujo no vive en el código de nadie. Orquéstrala para que alguien pueda ver el estado.
- No uses Kafka cuando una cola basta. Una cola durable de RabbitMQ maneja la mayoría de cargas de descarga de tareas; un broker de log compensa cuando necesitas replay, múltiples consumidores y retención — no para “enviar un email luego”.
Framework de Decisión
| Necesidad | Patrón | Protocolo |
|---|---|---|
| API pública | REST | HTTP/JSON |
| Alto rendimiento interno | gRPC | HTTP/2 + Protobuf |
| Dispara y olvida | Cola de mensajes | AMQP/Kafka |
| Múltiples consumidores | Pub/Sub | Kafka/NATS |
| Desacoplamiento entre equipos | Event-Driven | Kafka + Outbox |
| Control de tráfico | API Gateway | HTTP + plugins |
| mTLS, reintentos, trazas | Service Mesh | Istio/Linkerd |
| Agregación de peticiones | GraphQL | HTTP/JSON + esquema |
Lee la tabla como “empieza aquí, luego verifica contra tus restricciones”, no como un diagrama de flujo. La fila que más importa es la columna de fallos de la comparación anterior: si quien llama puede tolerar que el receptor esté caído, lo asíncrono responde la pregunta por ti; si no puede, elige el protocolo síncrono e invierte tu esfuerzo en timeouts y circuit breakers en lugar de brokers.
Buenas Prácticas
- Prefiere asíncrono para flujos con muchas escrituras — desacopla servicios, mejora la resiliencia
- Usa el patrón Outbox — asegura que los eventos se publiquen junto a la transacción de base de datos
- Haz los consumidores idempotentes — los mensajes pueden entregarse más de una vez
- Configura timeouts en llamadas síncronas — nunca dejes que quien llama se cuelgue indefinidamente
- Usa circuit breakers para llamadas síncronas — falla rápido cuando un servicio de destino está caído
- Versiona tus eventos — puede que no todos los consumidores se actualicen a la vez
- Usa dead-letter queues — los mensajes que fallan van a la DLQ para investigación
- Monitorea la latencia de extremo a extremo — los pipelines asíncronos acumulan latencia entre saltos
- Mantén los eventos pequeños — usa el patrón Claim Check para payloads grandes
- Usa un schema registry — garantiza la compatibilidad de esquemas de eventos (Avro, Protobuf)
Errores Comunes
- Usar REST para todo — acoplamiento fuerte, fallos en cascada
- No manejar mensajes duplicados — la idempotencia es obligatoria en consumidores asíncronos
- Encadenar llamadas síncronas en profundidad — la latencia se acumula, la probabilidad de fallo sube
- No usar el patrón Outbox — la doble escritura a base de datos + broker no es atómica
- Ignorar el orden de los mensajes — algunos eventos deben procesarse en orden (p. ej., pedido creado antes que pedido cancelado)
- No limitar la concurrencia del consumidor — un consumidor lento puede agotar los recursos
- Mezclar síncrono y asíncrono para la misma operación — elige un patrón por flujo de trabajo
- No monitorear la profundidad de la cola — colas que crecen indican rezago del consumidor
See Also
Preguntas frecuentes
¿Debo usar REST o gRPC para comunicación interna?
Usa gRPC para llamadas internas entre servicios donde el rendimiento importa. Viene con menor latencia, payloads más pequeños y tipado fuerte. Usa REST para APIs públicas, endpoints de navegador e integraciones donde se requiere interoperabilidad HTTP/JSON.
¿Cuál es la diferencia entre una cola de mensajes y pub/sub?
En una cola de mensajes (punto a punto), cada mensaje lo consume exactamente un consumidor. En pub/sub, cada mensaje se entrega a todos los suscriptores. Usa colas para distribución de tareas (p. ej., procesar pedidos). Usa pub/sub para eventos de dominio (p. ej., pedido creado — inventario, envíos y analítica necesitan enterarse).
¿Cómo elijo entre síncrono y asíncrono para un flujo de trabajo?
Pregunta qué pasa si el servicio de destino está caído cuando llega la llamada. Si el usuario necesita la respuesta ya — una consulta de precio, una verificación de permisos — ve síncrono y protégelo con timeouts y un circuit breaker. Si el trabajo puede completarse después y quien llama solo necesita confirmación de que fue aceptado, ve asíncrono. Los flujos mixtos son normales: lectura síncrona para la respuesta, evento publicado para todo lo demás.
¿Qué es un monolito distribuido y cómo lo evito?
Un sistema donde los servicios se despliegan por separado pero no pueden funcionar de forma independiente — cada petición los atraviesa síncronamente. Lo evitas eliminando saltos: desnormaliza datos de lectura, saca el trabajo no bloqueante a eventos y fusiona servicios que siempre cambian juntos. Si una acción del usuario requiere que cinco servicios estén sanos a la vez, tienes uno.
¿Necesito un service mesh?
Un service mesh es útil cuando tienes muchos microservicios (10+) y necesitas mTLS consistente, división de tráfico, reintentos y observabilidad sin modificar el código de aplicación. Para menos servicios, librerías como resilience4j o Polly manejan reintentos y circuit breaking dentro del proceso.
Recursos Relacionados
Arquitectura de Microservicios — Cuándo Usarla y Cuándo No
Guía práctica de microservicios: beneficios, trade-offs, patrones comunes y cuándo elegirlos sobre monolitos. Cubre estrategias de descomposición y complejidad operativa.
GuideGuía Completa de Sistemas Event-Driven
Diseña backends event-driven: event sourcing, CQRS, sagas, outbox pattern, idempotency, eventual consistency y patrones de producción.
GuidegRPC en Microservicios — Guía de RPC de Alto Rendimiento
Guía práctica de gRPC para microservicios: Protocol Buffers, streaming, balanceo de carga y migración desde REST para RPC de alto rendimiento.
PatternPatrón Circuit Breaker en Python, JavaScript y Java
Previene fallos en cascada deteniendo solicitudes a servicios que están fallando. Un patrón arquitectural para sistemas distribuidos resilientes.
GuideGuía Completa de GraphQL Federation
Construye APIs GraphQL unificadas con Apollo Federation. Cubre subgraphs, supergraph, resolución de entidades y despliegue de gateway.
GuideGuía Completa de Kafka Stream Processing
Construye pipelines de eventos en tiempo real con Kafka: producers, consumers, Kafka Streams, Connect, schema registry y patrones.