Trazado distribuido: OpenTelemetry, Jaeger y Zipkin
Domina el trazado distribuido con OpenTelemetry, Jaeger y Zipkin. Propagación de trazas entre servicios, contexto de span, estrategias de muestreo y depuración en producción.
Introducción
Una petición en un sistema de microservicios atraviesa un gateway, un servicio de autenticación, un par de backends, una base de datos y quizá una cola — y cuando va lenta, nadie sabe dónde se fue el tiempo. Los logs dicen lo que hizo cada servicio; el trazado distribuido dice dónde gastó la petición sus milisegundos.
Esta guía monta un setup de trazado de producción de principio a fin: instrumentación de servicios con OpenTelemetry en Python, Node y Java, propagación de contexto a través de HTTP y Kafka, elección de una estrategia de muestreo que encaje con tu tráfico, el OTel Collector delante de Jaeger o Zipkin, y la lectura de trazas para encontrar bugs reales. Todos los ejemplos son ejecutables — lo único que adaptarás es el endpoint del exportador.
Si antes quieres el recorrido conceptual, la guía de trazado distribuido cubre el ángulo de “qué es una traza”; esta va directa a la implementación. Para OpenTelemetry más allá del trazado (métricas y logs), consulta la guía de OpenTelemetry.
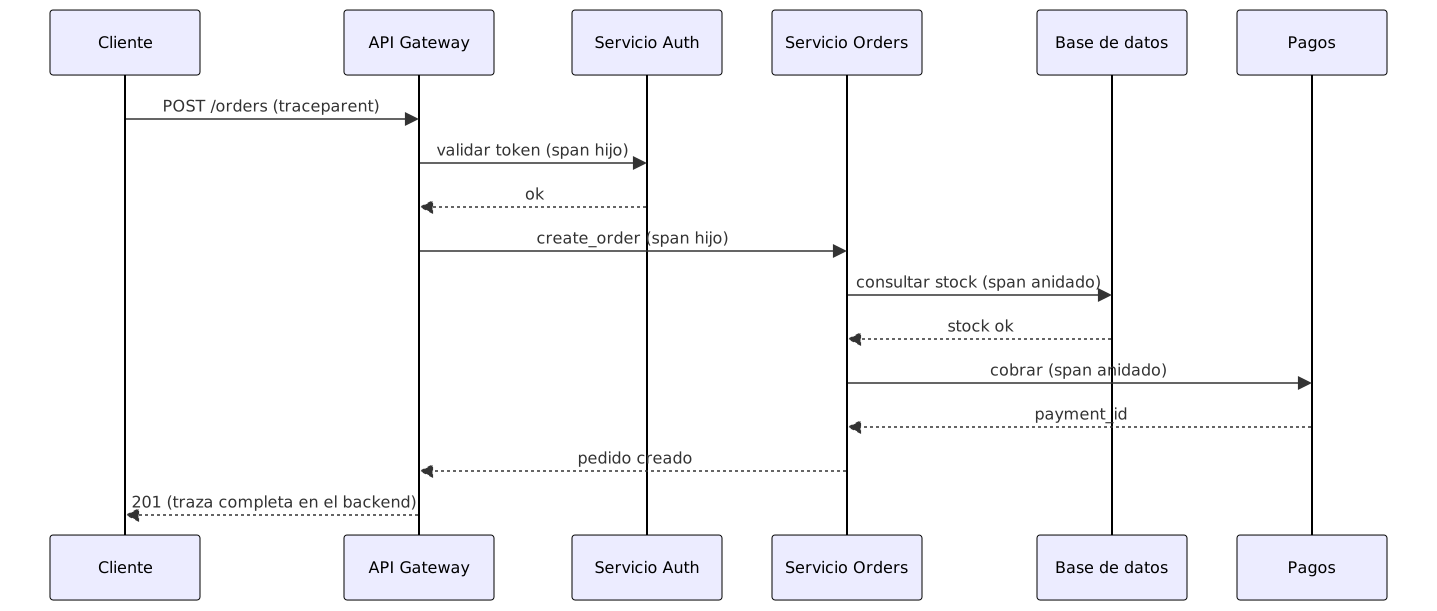
Conceptos fundamentales
Tres términos sostienen todo lo demás. Una traza es el recorrido completo de una petición — la unidad que ves como cascada en Jaeger. Un span es una unidad de trabajo dentro de ella (una llamada a servicio, una query de base de datos), con trace_id, span_id, parent_span_id, tiempos, atributos (metadatos clave-valor) y eventos (líneas de log con timestamp dentro del span). El contexto es el par trace_id + span_id que viaja entre servicios para que cada uno pueda colgar sus spans de la misma traza.
Traza: el recorrido completo de una petición por todos los servicios
  ├── Span A (Servicio: API Gateway)         [0ms - 150ms]
  │   ├── Span B (Servicio: Auth)            [5ms - 20ms]
  │   ├── Span C (Servicio: Orders)          [20ms - 140ms]
  │   │   ├── Span D (Base de datos)         [25ms - 50ms]
  │   │   ├── Span E (Inventario)            [55ms - 90ms]
  │   │   └── Span F (Pagos)                 [95ms - 135ms]
  │   └── Span G (Respuesta)                 [140ms - 150ms]

Span: una unidad de trabajo (una llamada a servicio, una query)
  - Tiene trace_id, span_id, parent_span_id
  - Tiene hora de inicio, duración y estado
  - Tiene atributos (metadatos clave-valor)
  - Tiene eventos (logs con timestamp dentro del span)

Contexto: el trace_id y span_id propagados entre servicios
  - Viaja por cabeceras HTTP, metadata gRPC o headers de mensajes
  - W3C Trace Context es el formato estándar
Dos detalles que conviene memorizar. Los atributos se indexan y son baratos de consultar en el backend; los eventos son solo marcas de tiempo dentro del span y no se pueden consultar — IDs en atributos, narrativa en eventos. Y hay una tercera cosa que se propaga además del contexto: el baggage, pares clave-valor arbitrarios (como tenant.id) que viajan con la traza hasta cada servicio aguas abajo. Úsalo con moderación — infla todas las cabeceras.
Instrumentación con OpenTelemetry
La auto-instrumentación parchea las librerías que ya usas — Flask, Express, Spring, clientes HTTP, drivers de base de datos — y produce spans sin tocar el código de negocio. Cubre la fontanería. Lo que no puede ver es tu lógica de dominio: “create_order” y “charge_customer” son palabras tuyas, así que esos spans los escribes tú. Los servicios reales usan ambas: auto para los bordes, spans manuales para los pasos de negocio intermedios.
Python: auto-instrumentación
# instrumentation.py — auto-instrumentación de OpenTelemetry para Python
from opentelemetry import trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.exporter.otlp.proto.grpc.trace_exporter import OTLPSpanExporter
from opentelemetry.sdk.resources import Resource

# Configura el tracer
resource = Resource.create({
    "service.name": "order-service",
    "service.version": "1.0.0",
    "deployment.environment": "production",
})

provider = TracerProvider(resource=resource)
processor = BatchSpanProcessor(
    OTLPSpanExporter(endpoint="http://otel-collector:4317")
)
provider.add_span_processor(processor)
trace.set_tracer_provider(provider)

# Auto-instrumentación para librerías comunes
from opentelemetry.instrumentation.flask import FlaskInstrumentor
from opentelemetry.instrumentation.requests import RequestsInstrumentor
from opentelemetry.instrumentation.sqlalchemy import SQLAlchemyInstrumentor
from opentelemetry.instrumentation.redis import RedisInstrumentor

FlaskInstrumentor().instrument_app(app)
RequestsInstrumentor().instrument()
SQLAlchemyInstrumentor().instrument(engine=db.engine)
RedisInstrumentor().instrument()
Dos piezas de este bloque rinden todos los días: el Resource (es lo que aparece como nombre de servicio en Jaeger — olvídalo y tus spans caen como unknown_service) y BatchSpanProcessor, que acumula spans y los exporta por lotes en lugar de una llamada de red por span. Nunca uses el SimpleSpanProcessor síncrono en producción.
Python: spans manuales
# order_service.py — creación manual de spans
from opentelemetry import trace
from opentelemetry.trace import Status, StatusCode

tracer = trace.get_tracer(__name__)

class OrderService:
    def create_order(self, user_id: int, items: list[dict]) -> dict:
        with tracer.start_as_current_span("create_order") as span:
            span.set_attribute("user.id", user_id)
            span.set_attribute("items.count", len(items))

            try:
                # Validar usuario
                with tracer.start_as_current_span("validate_user") as child:
                    user = self.auth_client.get_user(user_id)
                    child.set_attribute("user.email", user["email"])
                    child.set_attribute("user.active", user["is_active"])

                # Consultar inventario
                with tracer.start_as_current_span("check_inventory") as child:
                    for item in items:
                        stock = self.inventory_client.get_stock(item["product_id"])
                        child.set_attribute(f"product.{item['product_id']}.stock", stock)
                        if stock < item["quantity"]:
                            raise ValueError(f"Insufficient stock for product {item['product_id']}")

                # Procesar pago
                with tracer.start_as_current_span("process_payment") as child:
                    payment = self.payment_client.charge(
                        user_id=user_id,
                        amount=sum(i["price"] * i["quantity"] for i in items),
                    )
                    child.set_attribute("payment.id", payment["id"])
                    child.set_attribute("payment.amount", payment["amount"])

                # Guardar pedido
                with tracer.start_as_current_span("save_order") as child:
                    order = self.order_repo.create(user_id=user_id, items=items, payment_id=payment["id"])
                    child.set_attribute("order.id", order["id"])

                span.set_attribute("order.id", order["id"])
                span.set_status(Status(StatusCode.OK))
                return order

            except Exception as e:
                span.record_exception(e)
                span.set_status(Status(StatusCode.ERROR, str(e)))
                raise
Fíjate en el patrón: los bloques anidados de start_as_current_span crean el árbol padre-hijo automáticamente, y la rama except registra la excepción y marca el span como ERROR — ese estado de error es lo que permite al muestreo tail y al filtro de errores de Jaeger encontrarlo después.
TypeScript: instrumentación en Node.js
// tracing.ts — OpenTelemetry para Node.js
import { NodeSDK } from "@opentelemetry/sdk-node";
import { OTLPTraceExporter } from "@opentelemetry/exporter-trace-otlp-grpc";
import { Resource } from "@opentelemetry/resources";
import { ATTR_SERVICE_NAME, ATTR_SERVICE_VERSION } from "@opentelemetry/semantic-conventions";
import { ExpressInstrumentation } from "@opentelemetry/instrumentation-express";
import { HttpInstrumentation } from "@opentelemetry/instrumentation-http";
import { PgInstrumentation } from "@opentelemetry/instrumentation-pg";
import { RedisInstrumentation } from "@opentelemetry/instrumentation-redis-4";
import { trace, context, SpanStatusCode } from "@opentelemetry/api";

const sdk = new NodeSDK({
  resource: new Resource({
    [ATTR_SERVICE_NAME]: "api-gateway",
    [ATTR_SERVICE_VERSION]: "1.0.0",
  }),
  traceExporter: new OTLPTraceExporter({
    url: "http://otel-collector:4317",
  }),
  instrumentations: [
    new HttpInstrumentation(),
    new ExpressInstrumentation(),
    new PgInstrumentation(),
    new RedisInstrumentation(),
  ],
});

sdk.start();

// Spans manuales
const tracer = trace.getTracer("api-gateway");

async function handleRequest(req: Request, res: Response) {
  const span = tracer.startSpan("handle_request", {
    attributes: {
      "http.method": req.method,
      "http.url": req.url,
      "user.id": req.userId,
    },
  });

  try {
    await context.with(trace.setSpan(context.active(), span), async () => {
      const authResult = await validateToken(req.headers.authorization);
      const userData = await fetchUserData(req.userId);
      const processedData = await processData(userData);

      span.setAttribute("response.size", JSON.stringify(processedData).length);
      span.setStatus({ code: SpanStatusCode.OK });
      res.json(processedData);
    });
  } catch (error) {
    span.recordException(error);
    span.setStatus({ code: SpanStatusCode.ERROR, message: error.message });
    res.status(500).json({ error: "Internal server error" });
  } finally {
    span.end();
  }
}
La API de Node separa la creación del span (tracer.startSpan) de su activación: context.with(trace.setSpan(context.active(), span), fn) convierte el span en el actual para todo lo que corra dentro de fn, que es lo que permite a la auto-instrumentación de aguas abajo colgar sus spans como hijos. Cerrar el span en finally no es opcional — los spans sin cerrar gotean.
Java: instrumentación en Spring Boot
// TracingConfig.java — OpenTelemetry para Spring Boot
import io.opentelemetry.api.OpenTelemetry;
import io.opentelemetry.api.GlobalOpenTelemetry;
import io.opentelemetry.api.common.Attributes;
import io.opentelemetry.sdk.OpenTelemetrySdk;
import io.opentelemetry.sdk.trace.SdkTracerProvider;
import io.opentelemetry.sdk.trace.export.BatchSpanProcessor;
import io.opentelemetry.exporter.otlp.trace.OtlpGrpcSpanExporter;
import io.opentelemetry.sdk.resources.Resource;
import io.opentelemetry.semconv.ResourceAttributes;

@Configuration
public class TracingConfig {

    @Bean
    public OpenTelemetry openTelemetry() {
        Resource resource = Resource.getDefault()
            .merge(Resource.create(Attributes.of(
                ResourceAttributes.SERVICE_NAME, "order-service",
                ResourceAttributes.SERVICE_VERSION, "1.0.0",
                ResourceAttributes.DEPLOYMENT_ENVIRONMENT, "production"
            )));

        SdkTracerProvider tracerProvider = SdkTracerProvider.builder()
            .setResource(resource)
            .addSpanProcessor(BatchSpanProcessor.builder(
                OtlpGrpcSpanExporter.builder()
                    .setEndpoint("http://otel-collector:4317")
                    .build()
            ).build())
            .build();

        OpenTelemetrySdk sdk = OpenTelemetrySdk.builder()
            .setTracerProvider(tracerProvider)
            .build();

        GlobalOpenTelemetry.set(sdk);
        return sdk;
    }
}

// Spans manuales en el código del servicio
@Service
public class OrderService {

    private final Tracer tracer;

    public OrderService(OpenTelemetry openTelemetry) {
        this.tracer = openTelemetry.getTracer("order-service");
    }

    public Order createOrder(Long userId, List<OrderItem> items) {
        Span span = tracer.spanBuilder("create_order")
            .setAttribute("user.id", userId)
            .setAttribute("items.count", items.size())
            .startSpan();

        try (Scope scope = span.makeCurrent()) {
            User user = authService.validateUser(userId);
            Span validateSpan = tracer.spanBuilder("validate_user")
                .setAttribute("user.email", user.getEmail())
                .startSpan();
            validateSpan.end();

            Payment payment = paymentService.charge(userId, calculateTotal(items));
            Order order = orderRepository.save(new Order(userId, items, payment.getId()));

            span.setAttribute("order.id", order.getId());
            span.setStatus(StatusCode.OK);
            return order;
        } catch (Exception e) {
            span.recordException(e);
            span.setStatus(StatusCode.ERROR, e.getMessage());
            throw e;
        } finally {
            span.end();
        }
    }
}
En la práctica no escribirás casi nada de esto a mano: el agente Java de OpenTelemetry (-javaagent:opentelemetry-javaagent.jar) auto-instrumenta Spring, JDBC y clientes HTTP sin tocar código. La API manual de Span anterior es para las operaciones de negocio que el agente no puede nombrar por ti — el mismo reparto que en Python y Node.
Propagación de trazas
Una traza solo es traza si el contexto sobrevive a cada salto. El formato de propagación que habla todo el mundo es W3C Trace Context: una cabecera traceparent que lleva 00-{id de traza de 32 hex}-{id de span de 16 hex}-{flags}, más un tracestate opcional para datos de proveedor. Los propagadores de OTel cubren ambas direcciones — inject escribe el contexto actual en las cabeceras salientes, extract lo lee del lado receptor.
Propagación por HTTP
# Formato W3C Trace Context
# traceparent: 00-{trace-id}-{parent-span-id}-{trace-flags}
# Ejemplo: 00-0af7651916cd43dd8448eb211c80319c-b7ad6b7169203331-01

# Python: propagar contexto a través de llamadas HTTP
import requests
from opentelemetry import trace, propagate

def call_downstream_service(url: str, data: dict) -> dict:
    headers = {"Content-Type": "application/json"}

    # Inyectar el contexto de traza en las cabeceras
    current_span = trace.get_current_span()
    propagate.inject(headers)

    response = requests.post(url, json=data, headers=headers)
    return response.json()
// TypeScript: propagar contexto a través de llamadas fetch
import { propagation, context } from "@opentelemetry/api";
import { W3CTraceContextPropagator } from "@opentelemetry/core";
async function callDownstream(url: string, data: any): Promise<any> {
const headers: Record<string, string> = { "Content-Type": "application/json" };
// Inyectar el contexto de traza
propagation.inject(context.active(), headers, {
set: (carrier, key, value) => { carrier[key] = value; },
});
const response = await fetch(url, {
method: "POST",
headers,
body: JSON.stringify(data),
});
return response.json();
}Si estás auto-instrumentado, la propagación HTTP ya viene resuelta — requests, fetch y RestTemplate reciben la cabecera traceparent gratis. Inyectas a mano para clientes a medida, transportes no HTTP, o cuando la instrumentación se deja una librería fuera.
Propagación por colas de mensajes
Las colas son donde las trazas mueren más a menudo. Las cabeceras HTTP se propagan solas; los headers de mensajes de Kafka, no — el productor tiene que inyectar el contexto en los headers del mensaje, y el consumidor tiene que extraerlo y arrancar su span como hijo del productor:
# Kafka: propagar el contexto de traza por los headers del mensaje
from kafka import KafkaProducer, KafkaConsumer
from opentelemetry import trace, propagate

producer = KafkaProducer(bootstrap_servers=["localhost:9092"])

def send_event(topic: str, event: dict):
    headers = {}
    propagate.inject(headers)

    kafka_headers = [(k, v.encode("utf-8")) for k, v in headers.items()]
    producer.send(topic, value=json.dumps(event).encode("utf-8"), headers=kafka_headers)
    producer.flush()

consumer = KafkaConsumer("orders", bootstrap_servers=["localhost:9092"])

def consume_events():
    for message in consumer:
        # Extraer el contexto de traza de los headers del mensaje
        headers = {k: v.decode("utf-8") for k, v in message.headers}
        ctx = propagate.extract(headers)

        with tracer.start_as_current_span("process_event", context=ctx):
            event = json.loads(message.value)
            process_order_event(event)
Una advertencia estructural: los consumidores por lotes que procesan muchos mensajes por span producen trazas “fan-in” feas. Si cada mensaje merece su propia traza, usa span links (Span.fromContext + links=[...]) para asociar sin anidar — el backend los muestra como relacionados en lugar de anidados.
Estrategias de muestreo
Trazar sin muestrear a volumen sale caro: cada servicio exporta cada petición, y el backend lo almacena todo. A unos miles de peticiones por minuto, la factura de almacenamiento y de egress empieza a notarse — ahí entra el muestreo: conserva una fracción de las trazas y sigue viendo la forma del sistema.
Muestreo head-based (probabilístico)
# Muestrear un porcentaje de trazas en el punto de entrada
from opentelemetry.sdk.trace.sampling import TraceIdRatioBased, ALWAYS_ON

# Muestrear el 10% de las trazas
sampler = TraceIdRatioBased(0.1)

# O muestrear siempre (para desarrollo)
sampler = ALWAYS_ON

provider = TracerProvider(resource=resource, sampler=sampler)
El muestreo head decide cuando la traza empieza, antes de que ocurra nada. Es barato — la decisión es un hash del trace ID — pero ciego: un sampler al 10% conserva el 10% de tus errores, porque nadie sabe todavía que la petición va a fallar.
Muestreo tail-based (condicional)
El muestreo tail decide cuando la traza termina, en el collector, conociendo ya todos los spans. Es lo que permite decir “quédate con todos los errores y todas las trazas de más de 2 segundos, más un 10% del resto”:
# otel-collector-config.yaml — muestreo tail-based en el collector
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317

processors:
  tail_sampling:
    decision_wait: 10s
    num_traces: 100000
    policies:
      # Muestrear todos los errores
      - name: errors
        type: status_code
        status_code:
          status_codes: [ERROR]

      # Muestrear trazas lentas (>2s)
      - name: slow
        type: latency
        latency:
          threshold_ms: 2000

      # Muestrear el 10% de todo lo demás
      - name: baseline
        type: probabilistic
        probabilistic:
          sampling_percentage: 10

exporters:
  jaeger:
    endpoint: jaeger:14250
    tls:
      insecure: true

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [tail_sampling]
      exporters: [jaeger]
La contrapartida es la memoria: decision_wait define cuánto tiempo guarda el collector los spans mientras espera a los rezagados, y num_traces limita el pool de trazas que mantiene en RAM. Regla práctica de producción — muestreo head para desarrollo y servicios de poco volumen, muestreo tail cuando tienes suficiente tráfico como para que “conservar todos los errores” realmente ahorre almacenamiento.
Backends Jaeger y Zipkin
El backend guarda los spans y dibuja la cascada. Jaeger es el peso pesado: almacenamiento en Elasticsearch o Cassandra, grafos por servicio, pensado para escala. Zipkin es el original ligero: un solo binario, almacenamiento en memoria o MySQL/Elasticsearch, suficiente para despliegues pequeños. Una tercera opción que conviene conocer es Grafana Tempo — almacenamiento en objetos en lugar de Elasticsearch, mucho más barato a volumen, y consulta con TraceQL. Los tres aceptan OTLP, así que la instrumentación anterior no cambia.
Despliegue de Jaeger
# docker-compose.yml — Jaeger all-in-one para desarrollo
version: "3.8"
services:
  jaeger:
    image: jaegertracing/all-in-one:1.57
    ports:
      - "16686:16686"   # UI de Jaeger
      - "14250:14250"   # gRPC
      - "4317:4317"     # OTLP gRPC
      - "4318:4318"     # OTLP HTTP
    environment:
      - COLLECTOR_OTLP_ENABLED=true

  # En producción, Jaeger con almacenamiento Elasticsearch
  elasticsearch:
    image: docker.elastic.co/elasticsearch/elasticsearch:8.13.0
    environment:
      - discovery.type=single-node
      - xpack.security.enabled=false
    ports:
      - "9200:9200"
Despliegue de Zipkin
# docker-compose.yml — Zipkin para desarrollo
version: "3.8"
services:
  zipkin:
    image: openzipkin/zipkin:3.4
    ports:
      - "9411:9411"   # UI y API de Zipkin
    environment:
      - STORAGE_TYPE=mem  # Elasticsearch en producción
Consultar trazas
Ambos backends exponen la búsqueda de su UI como API REST — las mismas llamadas que hace la UI cuando filtras por servicio, duración o tags:
# API de Jaeger: buscar trazas de un servicio
curl "http://localhost:16686/api/traces?service=order-service&limit=20"

# API de Jaeger: buscar trazas con errores
curl "http://localhost:16686/api/traces?service=order-service&tags=error%3Dtrue"

# API de Zipkin: buscar trazas por nombre de span
curl "http://localhost:9411/api/v2/traces?spanName=create_order&limit=20"
OTel Collector
Tus aplicaciones podrían exportar directamente a Jaeger — pero entonces cada servicio guarda la configuración del backend, y cualquier cambio (endpoint nuevo, sampler nuevo, un segundo backend) obliga a tocarlos todos. El Collector se interpone: las apps exportan siempre a otel-collector:4317, y el collector decide qué pasa después — lotes, filtrado de ruido, muestreo tail, abanico hacia varios backends. Un solo lugar donde cambiar, cero redespliegues.
# otel-collector-config.yaml — configuración del collector en producción
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318

processors:
  batch:
    timeout: 5s
    send_batch_size: 1000

  memory_limiter:
    check_interval: 2s
    limit_percentage: 80
    spike_limit_percentage: 25

  resource:
    attributes:
      - key: deployment.environment
        value: production
        action: upsert

  filter:
    traces:
      deny:
        # Descartar spans de health check
        - attributes["http.route"] == "/health"

exporters:
  jaeger:
    endpoint: jaeger:14250
    tls:
      insecure: true

  zipkin:
    endpoint: http://zipkin:9411/api/v2/spans

  logging:
    loglevel: warn

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, filter, resource, batch]
      exporters: [jaeger]
El orden de los procesadores importa — memory_limiter va primero para que un pico de tráfico se descarte antes de que los demás procesadores gasten memoria en él, filter elimina pronto el ruido de health checks, y batch va último para comprimir lo que queda en exportaciones eficientes. La lista de exporters admite varios backends a la vez: mandar los mismos spans a Jaeger y a un backend gestionado solo te cuesta egress.
Patrones de depuración en producción
La instrumentación se paga el día en que producción va lenta y no sabes por qué. Estos tres patrones convierten las trazas de decoración en herramienta de depuración.
Encontrar peticiones lentas
# Añadir atributos propios para identificar operaciones lentas
with tracer.start_as_current_span("database_query") as span:
    start = time.time()
    result = db.execute(query)
    elapsed = time.time() - start

    span.set_attribute("db.duration_ms", elapsed * 1000)
    span.set_attribute("db.rows_returned", len(result))

    if elapsed > 1.0:
        span.set_attribute("db.slow_query", True)
        span.add_event("slow_query_detected", {
            "query": query[:200],
            "duration_ms": elapsed * 1000,
        })
El atributo db.slow_query se convierte en un tag filtrable en Jaeger — tags=slow_query:true en el buscador devuelve exactamente las trazas donde las queries se arrastraron, en lugar de ir cascada por cascada esperando dar con ellas.
Rastrear errores entre servicios
# Añadir detalles del error al span para depurar entre servicios
try:
    result = downstream_service.call(payload)
except requests.HTTPError as e:
    span = trace.get_current_span()
    span.record_exception(e)
    span.set_attribute("error.type", "http_error")
    span.set_attribute("error.status_code", e.response.status_code)
    span.set_attribute("error.response_body", e.response.text[:500])
    span.set_status(Status(StatusCode.ERROR, str(e)))
    raise
Registrar la excepción en el span que llama es lo que reconstruye la causalidad: el servicio de aguas abajo puede loguear un 500, pero la traza muestra que fue tu span process_payment el que falló porque validate_user devolvió datos obsoletos. Mantén error.response_body acotado — 500 caracteres bastan para la firma; una respuesta entera, no.
Contexto de negocio en las trazas
# Añadir atributos de negocio para filtrar en Jaeger/Zipkin
with tracer.start_as_current_span("process_checkout") as span:
    span.set_attribute("order.id", order.id)
    span.set_attribute("order.total", order.total)
    span.set_attribute("order.items_count", len(order.items))
    span.set_attribute("user.id", order.user_id)
    span.set_attribute("user.tier", user.tier)  # free, pro, enterprise
    span.set_attribute("payment.method", payment.method)
    span.set_attribute("checkout.flow", "standard")
Este es el patrón que paga el trazado por sí solo: user.tier=enterprise + error en el buscador es “muéstrame cada petición fallida de clientes de pago” — exactamente el conjunto que le importa a tu guardia.
Buenas prácticas
- Usa primero la auto-instrumentación — cubre llamadas HTTP, de base de datos y de caché automáticamente
- Añade spans manuales para la lógica de negocio — la auto-instrumentación no ve tu dominio
- Usa las convenciones semánticas — nombres de atributo estándar como
http.method,db.system - Define
service.nameyservice.versionen los atributos del recurso — identifican el servicio en la UI - Usa muestreo tail-based en producción — captura todos los errores y las trazas lentas, muestrea el resto
- Añade atributos de contexto de negocio — filtra trazas por ID de usuario, ID de pedido o feature flag
- Mantén los atributos de span pequeños — evita meter payloads grandes en ellos
- Usa eventos de span para logs con timestamp dentro del span — más útil que entradas de log sueltas
- Propaga el contexto por las colas de mensajes — no rompas la traza en los bordes asíncronos
- Filtra los spans de health check — ensucian los datos de trazas con ruido
Errores comunes
- No propagar el contexto: las llamadas a servicios de aguas abajo no llevan el contexto de traza y rompen la cadena. Inyecta y extrae contexto en cada borde de servicio.
- Demasiados spans: crear un span por cada llamada a función genera ruido. Crea spans en los bordes de servicio y en las operaciones de negocio relevantes.
- Errores sin registrar: se capturan excepciones pero no se registran en el span. Usa
span.record_exception(e)y marca el estado de error. - Solo muestreo head-based: pierdes todos los errores porque la decisión de muestreo se toma antes de que el error ocurra. Usa muestreo tail-based.
- Sin atributos de recurso: los spans aparecen como “unknown_service” en Jaeger. Define siempre
service.name.
Ver también
- Guía de trazado distribuido — el recorrido conceptual: qué son las trazas y cómo leer la cascada.
- Guía de OpenTelemetry — OTel más allá del trazado: métricas, logs y el SDK en profundidad.
- Guía de logging estructurado — emite
trace_iden los logs para correlacionarlos con los spans. - Observabilidad con el stack de Grafana — Tempo, Prometheus y Loki como backend completo.
Referencias externas:
- Documentación de OpenTelemetry — SDKs, instrumentaciones y convenciones semánticas.
- Especificación W3C Trace Context — el formato de cabeceras
traceparent/tracestate. - Documentación de Jaeger — arquitectura, backends de almacenamiento y despliegue en producción.
Preguntas frecuentes
¿Qué es el trazado distribuido?
Un método para seguir una sola petición mientras atraviesa varios servicios. Cada servicio añade un span a la traza, creando un árbol de spans que muestra el camino completo de la petición con tiempos y estado.
¿Qué es OpenTelemetry?
Un proyecto de la CNCF que ofrece APIs, SDKs y collectors neutros al proveedor para trazado distribuido, métricas y logs. Sustituye a la instrumentación propietaria de Jaeger, Zipkin y otros sistemas de trazado — instrumentas una vez y exportas donde quieras.
¿Muestreo head-based o tail-based?
El head-based decide al empezar la traza si se muestrea — rápido pero no puede tener en cuenta errores. El tail-based decide al terminar — puede conservar todos los errores y las trazas lentas, pero exige bufferar trazas en el collector. Head para desarrollo y poco volumen, tail para producción.
¿Jaeger, Zipkin o Tempo?
Jaeger para despliegues completos con almacenamiento Elasticsearch/Cassandra. Zipkin para montajes sencillos con un solo binario. Tempo para mucho volumen con poco presupuesto — guarda las trazas en almacenamiento de objetos (S3) en lugar de Elasticsearch, así que el coste de almacenamiento cae un orden de magnitud. Los tres aceptan OTLP; cambiar de backend no toca tu instrumentación.
¿Qué es un contexto de traza?
El trace ID, el span ID y las flags de traza que se propagan entre servicios. W3C Trace Context es el formato estándar, transmitido por las cabeceras HTTP traceparent y tracestate.
¿Cómo se conectan las trazas con los logs?
Emitiendo trace_id y span_id en los registros de log — las integraciones de logging de OpenTelemetry lo hacen automáticamente — tu plataforma de logs puede saltar de una línea de log a la traza completa. La mayoría de backends también enlazan al revés, de la traza a sus logs correlacionados. La guía de logging estructurado cubre la parte de logs del montaje.
¿Cuánto overhead añade el trazado?
Con procesamiento por lotes y un 10% de muestreo, el overhead es típicamente <1% de CPU y <5MB de memoria por servicio. El OTel Collector añade latencia mínima (<1ms por span). Usa el procesador memory_limiter para evitar OOM.
Recursos Relacionados
Trazas Distribuidas: Flujo de Peticiones en Microservicios
Guía práctica sobre trazas distribuidas: instrumentación de aplicaciones, propagación de trazas, estrategias de muestreo y diagnóstico de latencia en arquitecturas de microservicios con OpenTelemetry, Jaeger y Zipkin.
GuideOpenTelemetry
Guia practica de OpenTelemetry: instrumentacion, collectors, exporters, y conectar OTLP a backends como Jaeger, Prometheus y Grafana.
GuideLogging Estructurado: logs JSON, correlation IDs, agregación
Dominá structured logging con JSON format, correlation IDs, log levels y aggregation. Cubre Python structlog, Node.js pino, Java SLF4J, stacks ELK y Loki.
GuidePrometheus y Grafana: métricas, dashboards y alertas
Instrumenta servicios con métricas de Prometheus, consúltalas en PromQL, construye dashboards en Grafana y publica reglas de alerta que no oscilan.
GuideSentry: Triage y Resolución de Errores
Dominá Sentry para el seguimiento de errores en producción. Cubre integración del SDK en Python, Node.js y Java, release tracking, source maps, performance monitoring y alertas.
RecipeMonitoreo de Usuarios Reales (RUM) con web-vitals
Monitorea experiencias reales de usuarios con Core Web Vitals, session replay y análisis de performance para identificar cuellos de botella del mundo real.