Guía de OpenTelemetry: Trazas, Métricas y Logs
Guía práctica de OpenTelemetry en producción: instrumentación, collectors, estrategias de muestreo y pipelines OTLP hacia Jaeger, Prometheus y Grafana.
Visión general
OpenTelemetry (OTel) es un framework de observabilidad neutral respecto al proveedor para instrumentar, generar, recolectar y exportar datos de telemetría. Nació de la fusión de OpenTracing y OpenCensus bajo la CNCF, y hoy cubre las tres señales: trazas, métricas y logs. Instrumentas tu aplicación una vez y los datos pueden fluir a cualquier backend que hable OTLP: Jaeger, Tempo, Prometheus, Grafana, Datadog, New Relic o el servicio nativo de un proveedor cloud.
Esta guía recorre las piezas que importan en producción. Cubre cómo encajan el SDK y el Collector, cómo se ve código de instrumentación correcto, cómo configurar un pipeline del Collector y las decisiones que los equipos más suelen equivocar: muestreo, atributos de recurso y topología de despliegue. Si primero buscas el panorama general de observabilidad, Observabilidad — Métricas, Logs y Trazas es un buen punto de partida; esta guía asume que ya sabes por qué quieres telemetría y se centra en que OTel funcione bien.
En la práctica, cada señal responde a una pregunta distinta. Las trazas te dicen dónde pasó el tiempo una petición a través de los servicios. Las métricas te dan agregados en el tiempo: tasas de error, percentiles de latencia, saturación. Los logs aportan el detalle a nivel de evento detrás de un fallo concreto. La verdadera aportación de OTel es correlacionar las tres, de modo que un trace ID en una línea de log te lleva directo desde una alerta hasta la petición exacta que falló.
Cuándo usarla
- Quieres instrumentación que sobreviva a tu backend de observabilidad actual, de modo que un cambio de proveedor no implique re-instrumentar cada servicio.
- Necesitas trazas, métricas y logs de la misma aplicación con un contexto compartido.
- Estás migrando entre proveedores de observabilidad, o evaluando varios.
- Operas servicios políglotas (Go, Java, Python, Node.js, .NET) y quieres un modelo de instrumentación en lugar de cinco.
- Necesitas recolectar telemetría de servicios que no puedes modificar, a través de los receivers del Collector.
No la uses cuando tienes un único servicio y un agente del proveedor que funciona: OTel añade un SDK y un Collector que operar, y para una configuración trivial el beneficio es pequeño. En cuanto se suma un segundo equipo o servicio, gana el argumento de la estandarización.
Arquitectura
Tres capas hacen el trabajo en un despliegue de OpenTelemetry:

| Componente | Rol |
|---|---|
| API | La superficie de instrumentación que llama tu código. Se estabiliza antes que el SDK para que las librerías puedan instrumentar sin riesgo. |
| SDK | La implementación que crea, muestrea, almacena en búfer y exporta telemetría desde tu proceso. |
| Collector | Un servicio independiente que recibe OTLP, lo procesa y lo exporta a los backends. |
| OTLP | El protocolo de transporte. gRPC en el puerto 4317 o HTTP/protobuf en el 4318. |
| Convenciones semánticas | Nombres de atributos estándar (http.request.method, db.system, service.name) para que todas las herramientas lean los mismos datos. |
Las aplicaciones pueden exportar directo a un backend, pero en producción casi todo pasa por un Collector. El Collector desacopla tu app de la elección de backend, absorbe picos y centraliza tareas como el procesamiento por lotes, los reintentos y el filtrado de datos sensibles.
Instrumentar una aplicación
Auto-instrumentación
La auto-instrumentación es el camino más rápido a datos útiles. En Python, el paquete distro detecta los frameworks instalados y los parchea al arrancar:
pip install opentelemetry-distro opentelemetry-exporter-otlp
opentelemetry-bootstrap -a installOTEL_SERVICE_NAME=my-service \
OTEL_EXPORTER_OTLP_ENDPOINT=http://collector:4317 \
OTEL_TRACES_EXPORTER=otlp \
OTEL_METRICS_EXPORTER=otlp \
OTEL_LOGS_EXPORTER=otlp \
opentelemetry-instrument python myapp.pyLas variables de entorno forman parte de la spec y funcionan igual en todos los SDK. OTEL_SERVICE_NAME define service.name en el recurso, OTEL_EXPORTER_OTLP_ENDPOINT apunta a tu Collector o backend, y las tres variables *_EXPORTER eligen el exporter por señal.
Instrumentación manual
El error habitual en la configuración manual es crear exporters pero no conectarlos nunca a los providers. Un TracerProvider sin un span processor descarta cada span en silencio. Una configuración Python completa y funcional se ve así:
from opentelemetry import trace, metrics
from opentelemetry.sdk.resources import Resource
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.sdk.metrics import MeterProvider
from opentelemetry.sdk.metrics.export import PeriodicExportingMetricReader
from opentelemetry.exporter.otlp.proto.grpc.trace_exporter import OTLPSpanExporter
from opentelemetry.exporter.otlp.proto.grpc.metric_exporter import OTLPMetricExporter

resource = Resource.create({
    "service.name": "checkout-api",
    "service.version": "1.4.2",
    "deployment.environment.name": "production",
})

# Trazas: provider -> processor -> exporter
provider = TracerProvider(resource=resource)
provider.add_span_processor(BatchSpanProcessor(OTLPSpanExporter()))
trace.set_tracer_provider(provider)
tracer = trace.get_tracer(__name__)

# Métricas: provider -> reader -> exporter
reader = PeriodicExportingMetricReader(OTLPMetricExporter())
meter_provider = MeterProvider(resource=resource, metric_readers=[reader])
metrics.set_meter_provider(meter_provider)
meter = metrics.get_meter(__name__)

request_counter = meter.create_counter("http_requests_total")

with tracer.start_as_current_span("handle_request") as span:
    span.set_attribute("http.request.method", "GET")
    span.set_attribute("http.route", "/api/users")
    request_counter.add(1, {"method": "GET", "route": "/api/users"})
Aquí importan dos detalles. Primero, en producción usa siempre BatchSpanProcessor; el SimpleSpanProcessor síncrono exporta en cada span y bloquea los hilos de tu aplicación. Segundo, construye el Resource una vez y adjúntalo a cada provider, para que todas las señales compartan la misma identidad de servicio.
En Node.js, el punto de entrada equivalente es NodeSDK de @opentelemetry/sdk-node, que conecta exporters y auto-instrumentaciones en un solo objeto. La sección avanzada de abajo tiene un ejemplo completo.
El Collector
El Collector es un proceso agnóstico de proveedor organizado en pipelines: los receivers aceptan telemetría, los processors la transforman y los exporters la envían fuera. Defines un pipeline por señal y puedes compartir receivers entre ellos.
# otel-collector-config.yaml
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318

processors:
  batch:
    timeout: 1s
    send_batch_size: 1024

exporters:
  prometheusremotewrite:
    endpoint: http://mimir:9009/api/v1/push
  otlp/jaeger:
    endpoint: jaeger:4317
    tls:
      insecure: true
  otlphttp/loki:
    endpoint: http://loki:3100/otlp

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlp/jaeger]
    metrics:
      receivers: [otlp]
      processors: [batch]
      exporters: [prometheusremotewrite]
    logs:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlphttp/loki]
Vale la pena señalar algunos detalles de esta configuración porque los ejemplos antiguos los resuelven mal:
- El exporter
lokidedicado quedó deprecado y fue eliminado de la distribución contrib. Loki 3.x acepta OTLP de forma nativa, así que usaotlphttpapuntando a su endpoint/otlp. prometheusremotewriteempuja métricas a un endpoint remote write. Si tu Prometheus hace scraping, usa el exporterprometheus, que expone un endpoint/metricsen el Collector.tls.insecure: truesirve para un Jaeger local. En producción, configura TLS real o ejecuta el Collector detrás de un service mesh que gestione mTLS.
Topología agente vs. gateway
La mayoría de los despliegues en producción usan ambos roles:
| Rol | Despliegue | Función |
|---|---|---|
| Agente | DaemonSet o sidecar, uno por nodo | Recibir telemetría localmente, añadir metadatos del host y reenviar rápido |
| Gateway | Deployment o servicio independiente | Agregar, filtrar, muestrear y exportar a los backends |
Las apps envían al agente de su nodo, que reenvía al clúster gateway. Este patrón mantiene baja la latencia del lado de la app, aísla los fallos de exportación y te da un único punto donde aplicar políticas de muestreo y filtrado. Un gateway único también sirve para montajes pequeños; un despliegue solo de agentes tiene sentido cuando el backend es trivialmente accesible.
Estrategias de muestreo
El muestreo decide qué trazas conservar, y es donde la mayoría de despliegues de OTel ahorran o queman dinero.
El muestreo en cabeza toma la decisión al inicio del span, dentro del SDK. Es barato pero ciego: conservas un 10 % aleatorio de todo, incluidas las peticiones exitosas rutinarias. Se configura con variables de entorno:
OTEL_TRACES_SAMPLER=parentbased_traceidratio \
OTEL_TRACES_SAMPLER_ARG=0.1
El muestreo en cola toma la decisión en el Collector tras ver la traza completa. Puedes conservar todos los errores y las peticiones lentas mientras muestreas solo una fracción del tráfico sano:
processors:
  tail_sampling:
    decision_wait: 10s
    policies:
      - name: errors
        type: status_code
        status_code:
          status_codes: [ERROR]
      - name: slow-traces
        type: latency
        latency:
          threshold_ms: 2000
      - name: baseline
        type: probabilistic
        probabilistic:
          sampling_percentage: 10
El muestreo en cola requiere un despliegue del Collector donde todos los spans de una traza lleguen a la misma instancia, que es justo lo que te da la topología gateway. decision_wait controla cuánto retiene el Collector una traza antes de decidir; esperas más largas capturan trazas completas a costa de memoria.
| Muestreo en cabeza | Muestreo en cola | |
|---|---|---|
| Punto de decisión | SDK, al inicio del span | Collector, al completar la traza |
| Ve el resultado de la petición | No | Sí (errores, latencia, atributos) |
| Coste de infraestructura | Ninguno | Memoria del Collector para el búfer |
| Uso típico | Servicios de mucho volumen, control aproximado | Conservar cada error muestreando tráfico sano |
Una configuración habitual mezcla ambos: un ratio bajo de muestreo en cabeza en servicios de alto tráfico para proteger al Collector, más políticas en cola que garantizan que errores y valores atípicos nunca se descartan.
Atributos de recurso y convenciones semánticas
Los atributos de recurso describen qué produjo la telemetría: nombre del servicio, versión, entorno, host, región cloud, namespace de Kubernetes. Son la diferencia entre “subió la tasa de error” y “subió la tasa de error en checkout-api v1.4.2 en eu-west-1”.
Define los obvios en el recurso del SDK (como en el ejemplo de instrumentación) y deja que el Collector enriquezca el resto:
processors:
  resourcedetection:
    detectors: [env, system, docker, k8snode]
    timeout: 5s
Las convenciones semánticas estandarizan los nombres de atributos en todo el ecosistema: http.request.method, db.system, messaging.destination.name. Síguelas y cada dashboard, alerta y consulta funcionará igual independientemente del lenguaje. Inventar tus propios nombres es como terminas con http.method en un servicio y http_method en otro.
Propagación de contexto
OpenTelemetry propaga el contexto de traza entre servicios con las cabeceras W3C Trace Context:
traceparent: 00-0af7651916cd43dd8448eb211c80319c-b7ad6b7169203331-01
tracestate: vendor=value
La cabecera traceparent lleva el trace ID, el span ID padre y los flags de muestreo. tracestate contiene datos específicos del proveedor. Con la propagación funcionando, una petición que empieza en un frontend JavaScript continúa a través de backends en Node.js, Python y Go como una sola traza. La mayoría de clientes HTTP instrumentados inyectan las cabeceras automáticamente; si publicas en una cola o llamas a un servicio sin instrumentar, quizá tengas que inyectar y extraer el contexto a mano con los propagators de tu SDK.
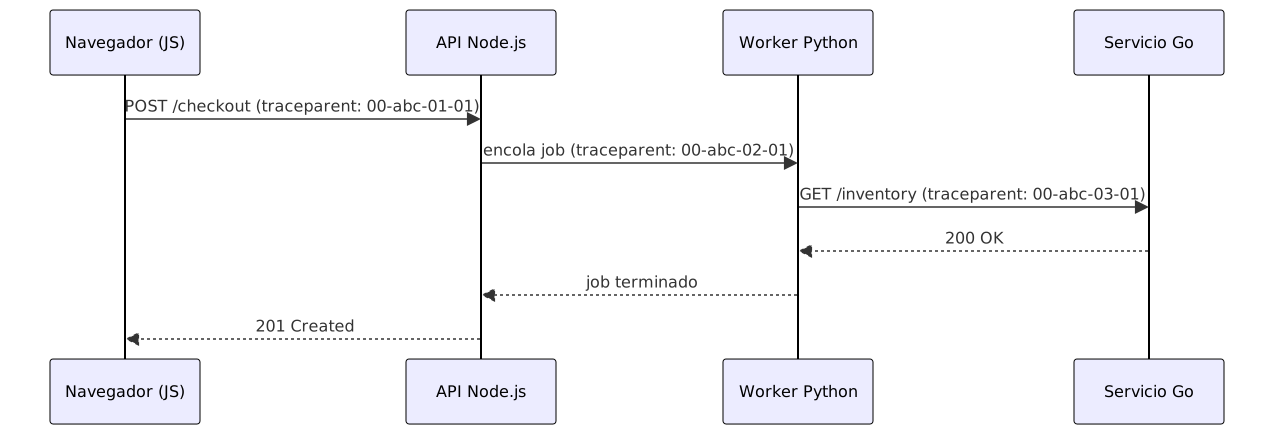
El trace ID (abc arriba, abreviado) se mantiene idéntico de extremo a extremo; solo cambia el parent span ID en cada salto.
baggage es una cabecera aparte para propagar pares clave-valor (ID de tenant, variante de experimento) junto a la traza. Manténla pequeña: viaja en cada petición.
Logs: puentear lo que ya tienes
Los logs de OTel son la señal más joven, y la mayoría de apps ya emiten logs con una librería madura. Rara vez hace falta reescribir código de logging. El enfoque práctico es puentear: los appenders de log del SDK adjuntan el contexto de traza (trace ID, span ID) a cada registro, y el Collector ingiere logs OTLP o ficheros vía el receiver filelog. Cuando los registros llevan el contexto de traza, tu backend puede saltar de una traza a sus líneas de log exactas y viceversa, que es donde aparece el verdadero valor de depuración. Si tu stack ya corre Fluent Bit o un agente similar, puede quedarse: envía su salida a los mismos backends y deja que el Collector gestione los servicios OTLP nativos.
Avanzado: ejemplo completo de instrumentación (Node.js)
Juntándolo todo, aquí va un servicio de e-commerce con auto-instrumentación más spans y métricas personalizadas alrededor del flujo de checkout:
import { NodeSDK } from "@opentelemetry/sdk-node";
import { getNodeAutoInstrumentations } from "@opentelemetry/auto-instrumentations-node";
import { OTLPTraceExporter } from "@opentelemetry/exporter-trace-otlp-grpc";
import { PrometheusExporter } from "@opentelemetry/exporter-prometheus";
import { trace, metrics, SpanStatusCode } from "@opentelemetry/api";

const sdk = new NodeSDK({
  traceExporter: new OTLPTraceExporter({ url: "http://otel-collector:4317" }),
  metricReader: new PrometheusExporter({ port: 9464 }),
  instrumentations: [getNodeAutoInstrumentations({
    "@opentelemetry/instrumentation-fs": { enabled: false },
  })],
});
sdk.start();

const tracer = trace.getTracer("ecommerce-api");
const meter = metrics.getMeter("ecommerce-api");

const checkoutCounter = meter.createCounter("checkouts.total", {
  description: "Total checkouts procesados",
});
const checkoutDuration = meter.createHistogram("checkout.duration", {
  description: "Duración del checkout en ms",
  unit: "ms",
});

async function checkout(cart) {
  const started = Date.now();
  return tracer.startActiveSpan("checkout", async (span) => {
    span.setAttribute("cart.items", cart.items.length);
    try {
      const validation = await tracer.startActiveSpan("validate_cart",
        async (child) => {
          try {
            const result = validateCart(cart);
            child.setAttribute("cart.valid", result.valid);
            return result;
          } finally {
            child.end();
          }
        });

      const payment = await tracer.startActiveSpan("process_payment",
        async (child) => {
          try {
            const result = await processPayment(cart);
            child.setAttribute("payment.status", result.status);
            return result;
          } finally {
            child.end();
          }
        });

      span.setStatus({ code: SpanStatusCode.OK });
      checkoutCounter.add(1, { status: "success", method: cart.paymentMethod });
      checkoutDuration.record(Date.now() - started, { status: "success" });
      return { validation, payment };
    } catch (error) {
      span.recordException(error);
      span.setStatus({ code: SpanStatusCode.ERROR, message: error.message });
      checkoutCounter.add(1, { status: "error" });
      throw error;
    } finally {
      span.end();
    }
  });
}
Dos hábitos hacen que este ejemplo tenga forma de producción y no de demo. Los spans hijos terminan dentro de finally para que un paso que lanza error no deje spans sin cerrar, y los códigos de estado vienen de SpanStatusCode en lugar de números mágicos. Las métricas personalizadas registran la dimensión de negocio (método de pago, resultado), que es sobre lo que realmente alertas y montas dashboards después.
Despliegue en producción
En Kubernetes, el despliegue estándar es un agente DaemonSet más un gateway Deployment. El OpenTelemetry Operator puede gestionar ambos y también inyectar auto-instrumentación en los pods mediante anotaciones como instrumentation.opentelemetry.io/inject-nodejs: "true", lo que evita tocar los manifiestos de la aplicación. El Operator también gestiona el recurso personalizado Instrumentation, donde fijas imágenes del SDK, endpoints de exporters y atributos de recurso de forma centralizada en lugar de repetirlos en cada despliegue.
Fuera de Kubernetes, el Collector se distribuye como un binario único o un contenedor y funciona bien como unidad de systemd o un pequeño despliegue en VM; la misma configuración de pipelines aplica.
Lo que funciona
Puntos prácticos que pasan factura a los equipos más tarde:
- Alta disponibilidad: ejecuta al menos dos réplicas del gateway detrás de un service. Un único Collector es un punto único de fallo para toda la telemetría.
- Cardinalidad: métricas con valores de etiqueta ilimitados (IDs de usuario, rutas crudas) disparan el almacenamiento y el coste. Mantén los valores acotados y normaliza las rutas (
/api/users/{id}, no/api/users/42). - Búfer: el processor
batchsuaviza los picos. Para durabilidad, las colas persistentes (extensiónfile_storage) sobreviven a reinicios del Collector. - Control de costes: cada señal tiene coste de salida y almacenamiento. El muestreo en cola sobre las trazas, descartar logs ruidosos en el Collector y reducir la cardinalidad de métricas son las tres grandes palancas. Mídelas pronto, no cuando llegue la primera factura grande.
Migrar desde agentes de proveedor
Si vienes de un cliente Jaeger, instrumentación Zipkin o un agente propietario, la migración es incremental. Sustituye el SDK del proveedor por el SDK de OTel; el modelo de datos encaja limpio porque OTel absorbió la semántica de los proyectos anteriores. Conserva el backend durante la transición: Jaeger acepta OTLP de forma nativa, así que exportar con otlp/jaeger mantiene las trazas idénticas en la UI de Jaeger mientras migras servicio a servicio. Para instrumentación que no puedes reescribir, los receivers zipkin, jaeger y statsd del Collector aceptan los formatos antiguos y los alimentan a los pipelines OTel sin cambios.
Para profundizar en el tracing, la guía de trazas distribuidas cubre diseño de spans, análisis de trazas y flujos de depuración con más detalle.
Errores comunes
- Olvidar el flush al apagar: los spans y métricas sin vaciar se pierden cuando un pod termina. Llama a
shutdown/forceFlushen los providers y da a los contenedores unterminationGracePeriodSecondsque permita completar el vaciado. - Exportar todo de forma síncrona:
SimpleSpanProcessor(o su equivalente) exporta por span y frena los hilos de petición. Procesa siempre por lotes. - Saltarse los atributos de recurso: sin
service.nameydeployment.environment.name, cada señal es un blob anónimo que no puedes filtrar. - Un único Collector para todo: un gateway sin agentes ni réplicas se convierte en cuello de botella y punto único de fallo.
- Dejar el muestreo por defecto:
parentbased_always_onconserva el 100 % de las trazas, razonable en desarrollo y caro a escala. - Métricas de cardinalidad alta: meter IDs de usuario o URLs crudas en las etiquetas es la forma más rápida de disparar la factura de métricas.
Solución de problemas
- No llegan spans al backend: comprueba endpoint y puerto OTLP (4317 gRPC frente a 4318 HTTP) y luego TLS.
tls.insecure: truecontra un endpoint con TLS habilitado falla en silencio en algunas versiones del SDK. - Collector OOMKilled: un
batchsin límites más un throughput alto agota la memoria. Bajasend_batch_size, añade réplicas y revisa si eldecision_waitdel tail_sampling es demasiado largo para tu tráfico. - Llegan métricas pero no trazas: los pipelines son independientes en
service.pipelines. Una entrada ausente bajotraces:hace que el Collector descarte las trazas en silencio. - Atributos duplicados o ausentes: dos detectores de
resourcedetectionen desacuerdo, o atributos definidos en spans en lugar del recurso. Los atributos de recurso viven una vez por servicio; los de span, por operación. - El muestreo no es el esperado: el muestreo en cabeza decidido en el SDK no puede re-decidirse más adelante. Si el gateway muestra ~100 % de las trazas, revisa primero
OTEL_TRACES_SAMPLER.
Lectura adicional
- Recursos complementarios: el pipeline del Collector, un script Python de instrumentación ejecutable y un stack docker-compose con Jaeger de esta guía.
- Documentación de OpenTelemetry: la referencia oficial de conceptos, SDKs y el Collector.
- Especificación OTLP: los detalles del protocolo de transporte.
- opentelemetry-collector-contrib: el catálogo completo de receivers, processors y exporters.
- Convenciones semánticas: los nombres de atributos estándar de todas las señales.
- W3C Trace Context: los headers
traceparent/tracestateque propagan el contexto entre servicios.
Preguntas frecuentes
¿OpenTelemetry está listo para producción?
Sí. Las trazas son estables en todos los lenguajes soportados, las métricas son estables en los SDK principales y los logs alcanzaron estabilidad en los lenguajes principales. Los componentes núcleo del Collector son estables; revisa el estado de cada processor y exporter contrib antes de depender de ellos.
¿Debo ejecutar el Collector como agente, gateway o ambos?
Ambos para cualquier cosa más allá de un prototipo. El agente (DaemonSet) recibe telemetría cerca de la app y añade metadatos del host; el gateway agrega, muestrea, filtra y exporta. Los montajes pequeños pueden empezar con un único gateway y añadir agentes al multiplicar los nodos.
¿Qué diferencia hay entre muestreo en cabeza y en cola?
El de cabeza decide al inicio del span dentro del SDK y no ve el resultado de la petición. El de cola espera la traza completa dentro del Collector, así que puede conservar todos los errores y las trazas lentas mientras reduce el tráfico sano. El de cabeza es barato; el de cola es más inteligente y cuesta memoria del Collector.
¿Puedo usar OpenTelemetry con mi Jaeger o Prometheus actual?
Sí. Jaeger ingiere OTLP de forma nativa, y Prometheus puede hacer scraping del exporter prometheus del Collector o recibir prometheusremotewrite. Normalmente conservas tu backend y solo cambia cómo llegan los datos.
¿Cómo migro desde un cliente Jaeger o un agente de proveedor?
Servicio a servicio. Cambia el SDK, apunta los exporters a OTLP y conserva el backend. Para agentes que no puedes reemplazar, el Collector tiene receivers zipkin, jaeger y statsd que aceptan formatos antiguos y los alimentan a los pipelines OTel.
¿Qué puerto usa OTLP, gRPC o HTTP?
gRPC es el 4317 y HTTP/protobuf el 4318. La mayoría de SDK asumen gRPC por defecto; los firewalls y balanceadores que tienen problemas con gRPC pueden usar el endpoint HTTP.
Recursos Relacionados
Guía Completa de Observabilidad con el Stack de Grafana
Monta el stack completo de observabilidad de Grafana: Prometheus, Loki, Tempo, Alloy y Grafana con un solo docker-compose, correlación de señales y alertado por SLO.
RecipeDistributed Tracing con OpenTelemetry
Cómo implementar distributed tracing en Python con OpenTelemetry SDK, incluyendo spans, propagación de context, auto-instrumentación y export a Jaeger.
GuideIngenieria de confiabilidad del sitio (SRE)
Guia practica de SRE: definir SLIs, SLOs y SLAs, gestionar presupuestos de error, reducir toil, rotaciones de guardia y construir una cultura de confiabilidad.
GuideTrazado distribuido: OpenTelemetry, Jaeger y Zipkin
Domina el trazado distribuido con OpenTelemetry, Jaeger y Zipkin. Propagación de trazas entre servicios, contexto de span, estrategias de muestreo y depuración en producción.
GuideAgregación de Logs
Guía práctica sobre agregación de logs: logs estructurados, estrategias de envío, políticas de retención y construcción de pipelines de logs consultables con ELK, Loki y soluciones nativas de la nube.
RecipeImplementar logging y audit trails de API
Configura logging de petición/respuesta y audit trails que pasan revisiones de compliance: salida estructurada, correlation IDs, enmascaramiento y almacenamiento append-only.