Bot de Slack con OpenAI: menciones, DMs y memoria
Un bot conversacional de Slack potenciado por OpenAI que responde menciones y mensajes directos, mantiene el historial por usuario y controla el gasto
Visión General
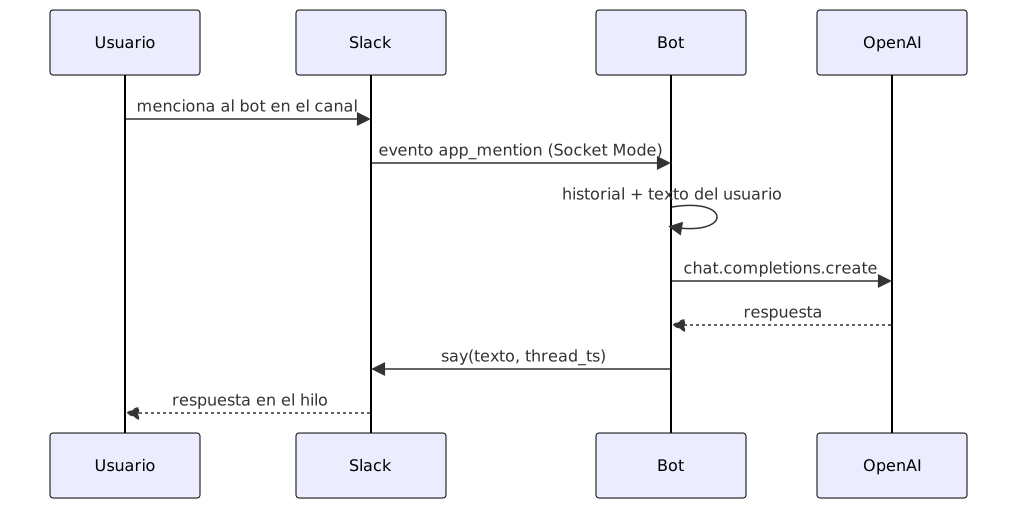
Enchufa un LLM a Slack y podrá responder preguntas, resumir hilos y ejecutar comandos justo donde tu equipo ya conversa. Esta receta conecta el Socket Mode de Slack Bolt (sin necesidad de una URL pública) con la API de chat completions de OpenAI, con memoria de conversación por usuario, respuestas en hilo y mensajes directos. Para un chatbot general sin Slack, consulta Chatbot con OpenAI.
Cuándo Usarlo
- Quieres un asistente dentro de Slack que ya conozca el contexto de tu equipo.
- Las mismas preguntas se repiten en los canales públicos y quieres responderlas de forma automática.
- Prefieres probar una interfaz conversacional en el chat antes de invertir en una UI.
- No lo apuntes a todos los mensajes de canales con mucho tráfico: sin filtrado ni límites por usuario, la factura de OpenAI te sorprenderá.
Requisitos Previos
- Una app de Slack con Bot Token y Socket Mode habilitado (obtendrás tokens
xoxb-yxapp-). - Una API key de OpenAI.
- Node.js 18+ o Python 3.10+.
Solución
Node.js
npm install @slack/bolt openai dotenv# .env
SLACK_BOT_TOKEN=xoxb-your-bot-token
SLACK_SIGNING_SECRET=your-signing-secret
SLACK_APP_TOKEN=xapp-your-app-token
OPENAI_API_KEY=sk-your-openai-key// app.js
import { App } from '@slack/bolt';
import OpenAI from 'openai';
import dotenv from 'dotenv';
dotenv.config();
const slack = new App({
token: process.env.SLACK_BOT_TOKEN,
signingSecret: process.env.SLACK_SIGNING_SECRET,
appToken: process.env.SLACK_APP_TOKEN,
socketMode: true,
});
const openai = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });
// Almacén de conversaciones en memoria (usa Redis en producción)
const conversations = new Map();
function getHistory(userId) {
if (!conversations.has(userId)) {
conversations.set(userId, [{ role: 'system', content: 'Eres un asistente útil en un workspace de Slack.' }]);
}
return conversations.get(userId);
}
async function getGPTResponse(messages) {
const response = await openai.chat.completions.create({
model: 'gpt-4o-mini',
messages,
max_tokens: 500,
});
return response.choices[0].message.content;
}
// Responde a menciones en canales
slack.event('app_mention', async ({ event, say }) => {
const text = event.text.replace(/<@[^>]+>/, '').trim();
if (!text) return; // mención sin pregunta
const history = getHistory(event.user);
history.push({ role: 'user', content: text });
const reply = await getGPTResponse(history);
history.push({ role: 'assistant', content: reply });
// Conserva el prompt de sistema más los últimos 10 mensajes
if (history.length > 11) {
conversations.set(event.user, [history[0], ...history.slice(-10)]);
}
await say({ text: reply, thread_ts: event.ts });
});
// Responde a mensajes directos — ignora bots, tráfico que no es DM y texto vacío
slack.message(async ({ message, say }) => {
if (message.bot_id || message.subtype || message.channel_type !== 'im' || !message.text?.trim()) {
return;
}
const history = getHistory(message.user);
history.push({ role: 'user', content: message.text });
const reply = await getGPTResponse(history);
history.push({ role: 'assistant', content: reply });
await say(reply);
});
(async () => {
await slack.start();
console.log('Bot de Slack en ejecución');
})();node app.jsPython
pip install slack-bolt openai python-dotenv# bot.py
import os
from slack_bolt import App
from slack_bolt.adapter.socket_mode import SocketModeHandler
from openai import OpenAI
from dotenv import load_dotenv
load_dotenv()
app = App(token=os.environ["SLACK_BOT_TOKEN"])
openai_client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])
conversations = {}
def get_history(user_id):
if user_id not in conversations:
conversations[user_id] = [
{"role": "system", "content": "Eres un asistente útil en un workspace de Slack."}
]
return conversations[user_id]
def get_gpt_response(messages):
response = openai_client.chat.completions.create(
model="gpt-4o-mini",
messages=messages,
max_tokens=500,
)
return response.choices[0].message.content
@app.event("app_mention")
def handle_mention(event, say):
import re
text = re.sub(r"<@[^>]+>", "", event["text"]).strip()
if not text:
return # mención sin pregunta
history = get_history(event["user"])
history.append({"role": "user", "content": text})
reply = get_gpt_response(history)
history.append({"role": "assistant", "content": reply})
if len(history) > 11:
conversations[event["user"]] = [history[0]] + history[-10:]
say(text=reply, thread_ts=event["ts"])
@app.message("")
def handle_dm(message, say):
# Ignora bots, tráfico que no es DM y texto vacío
if message.get("bot_id") or message.get("subtype") or message.get("channel_type") != "im":
return
if not message.get("text", "").strip():
return
history = get_history(message["user"])
history.append({"role": "user", "content": message["text"]})
reply = get_gpt_response(history)
history.append({"role": "assistant", "content": reply})
say(reply)
if __name__ == "__main__":
handler = SocketModeHandler(app, os.environ["SLACK_APP_TOKEN"])
handler.start()Cómo Funciona
- Socket Mode: el bot abre una conexión WebSocket hacia Slack, así que funciona detrás de un firewall sin endpoint público. Bolt confirma los eventos por ti, y eso importa porque Slack reintenta todo lo que no se confirma en ~3 segundos.
- Memoria de conversación: cada usuario tiene una ventana móvil (prompt de sistema + últimos 10 mensajes). Un
Map/dictvive y muere con el proceso — usa Redis para algo serio. - Hilos: las respuestas en canal pasan
thread_ts, así quedan pegadas al mensaje que las disparó en lugar de inundar el canal. - Mensajes directos: los DMs tienen su propio handler con guardas de
bot_id, subtype y texto vacío para que el bot no entre en bucle respondiéndose a sí mismo.
Variantes
| Variante | Cuándo elegirla |
|---|---|
| Node.js + Socket Mode | Opción por defecto; corre en cualquier sitio sin URL pública |
Python + SocketModeHandler | El mismo flujo para equipos Python (slack-bolt + openai) |
| Endpoint HTTP de eventos | Cuando ya expones una URL pública y prefieres request/response en vez de un socket persistente |
| Resumidor de hilos | Escucha eventos de hilo y ofrece resúmenes TL;DR bajo demanda |
| Entrada de imágenes | Reenvía imágenes subidas a un modelo con visión (p. ej. gpt-4o) |
Lo que funciona
- Cambia el almacén en memoria por Redis en despliegues multi-instancia — un reinicio borra todas las conversaciones si no. Consulta Rate Limiting de APIs con Redis para patrones de Redis.
- Trunca por tokens, no por mensajes. Diez mensajes largos pueden reventar la ventana de contexto; cuenta tokens con
tiktokenen lugar de un “últimos 10” fijo. - Pon un tope de gasto por usuario. Un solo usuario insistiendo puede quemar todo el presupuesto de OpenAI — impón una cuota diaria de requests o tokens por user ID.
- Reintenta las llamadas a OpenAI con backoff. Los rate limits y los errores de red transitorios son normales; envuelve la llamada como en Retry con Backoff Exponencial.
- Registra cada interacción: quién preguntó, dónde, cuándo y cuántos tokens gastó. La necesitas para auditar costes y depurar respuestas raras.
- Expón un endpoint
/healthcuando el bot corra como servicio, para que el monitoreo distinga “bot caído” de “Slack caído”. - Filtra antes de gastar. Revisa
bot_id, subtype y texto vacío antes de llamar a OpenAI — filtrar después de la llamada igualmente cuesta tokens.
Errores Comunes
- Confirmar tarde — Slack reintenta cualquier evento no confirmado en ~3 segundos, así que acabas respondiendo el mismo mensaje dos veces. Bolt confirma por ti; en un endpoint propio, confirma primero y procesa en async.
- Subir archivos
.envo tokens a git — las claves van en variables de entorno o en un gestor de secretos, nunca en código. - No filtrar los mensajes del propio bot — revisa
message.bot_idy sáltalo, o el bot se responde a sí mismo para siempre. - Ignorar el contexto del hilo — una pregunta de seguimiento dentro de un hilo necesita los mensajes anteriores; recupéralos con la API
conversations.repliesde Slack. - Llamar a la API sin
max_tokens— una respuesta sin tope puede gastar el presupuesto en una sola llamada. - Responder a texto vacío o menciones sin pregunta — valida
message.textantes de gastar tokens. - Olvidar el rate limit de Slack (~1 mensaje por segundo por canal) — encola o agrupa las respuestas en canales concurridos.
Checklist de Producción
- API keys en variables de entorno, no en código
- El bot filtra
bot_id, subtypes y mensajes vacíos - Historial persistido en Redis o Postgres (no en memoria)
- Límites por usuario (máx. requests o tokens por día)
- Llamadas a OpenAI con timeout y retry con backoff
- Uso de tokens registrado por request para controlar el gasto
- Errores mostrados al usuario amigables (sin errores crudos de la API)
- Respuestas en canal publicadas en hilos
- Endpoint
/healthexpuesto para monitoreo - Logs estructurados con correlation IDs para depurar
Ver También
- Slack API — Socket Mode — entrega de eventos sin URL pública.
- Slack API — conversations.replies — recupera el historial del hilo para dar contexto.
- Referencia de la API de OpenAI — parámetros de chat completions y el campo
usage. - Repositorio companion —
app.js,bot.pyy.env.exampleejecutables.
Preguntas frecuentes
¿Cuánto cuesta ejecutar esto?
gpt-4o-mini cuesta aproximadamente $0.15 por 1M de tokens de entrada y $0.60 por 1M de tokens de salida, así que un intercambio corto cuesta bastante menos de un céntimo. Lee el campo usage en cada respuesta y configura una alerta cuando el gasto diario supere tu umbral.
¿El bot puede ver el historial del canal?
Solo con el scope channels:history, y solo los mensajes publicados después de unirse. Revisa primero la política de privacidad de tu empresa: el bot guarda todo lo que lee.
¿Cómo añado contexto de hilo a las respuestas?
Llama a conversations.replies con el ts del hilo, toma los últimos 5-10 mensajes y añádelos al principio del array de messages. Sin esto, el bot responde cada mensaje del hilo de forma aislada.
¿Cómo limito el bot a canales concretos?
Mantén una lista permitida de IDs de canal en la config o las variables de entorno; si event.channel no está en ella, sal antes.
¿Puedo usar function calling con el bot de Slack?
Sí — declara tools como search_knowledge_base en el request de OpenAI, ejecuta la función cuando el modelo devuelva un tool call y devuelve el resultado para una segunda completion. Consulta Agentes de IA con Uso de Herramientas.
¿Cómo lo despliego en producción?
Empaquétalo como contenedor Docker y ejecútalo en ECS, Kubernetes o un VPS con pm2/systemd. Socket Mode no necesita puertos de entrada; añade un health check y auto-restart y listo.
¿Cómo manejo muchos usuarios escribiendo a la vez?
Socket Mode entrega eventos concurrentemente, pero una llamada lenta a OpenAI bloquea el siguiente request de ese usuario. Encola por usuario o usa un pool pequeño de workers para que una conversación larga no pare a los demás.
Recursos Relacionados
Chatbot con OpenAI Assistants API: Build, Coste y Deploy
Cómo crear un chatbot de IA usando la OpenAI Assistants API con function calling y file search.
RecipeAgentes de IA con Uso de Herramientas: ReAct en Práctica
Construye agentes de IA autónomos que pueden usar herramientas y APIs externas para completar tareas complejas.
RecipeImplementar Rate Limiting de APIs con Redis
Protege APIs del abuso con limitadores token bucket y ventana deslizante respaldados por Redis, con ráfagas controladas y coordinación distribuida
RecipeRAG con LangChain y bases vectoriales
Cómo construir un pipeline de Retrieval-Augmented Generation (RAG) usando LangChain y bases de datos vectoriales para búsqueda potenciada por IA